Карточки товаров
Покажите товар в новом цвете
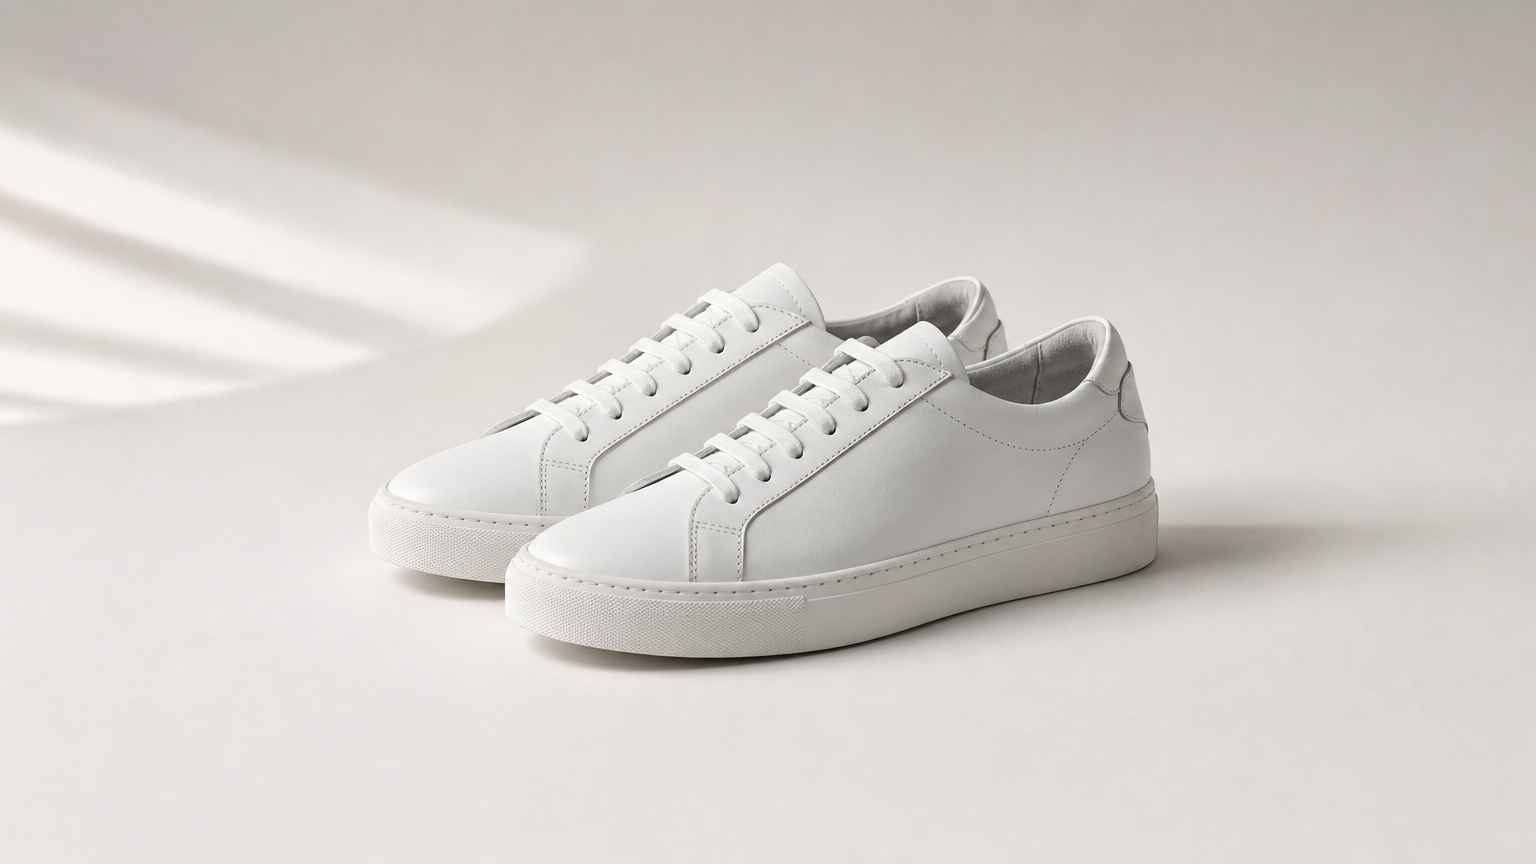
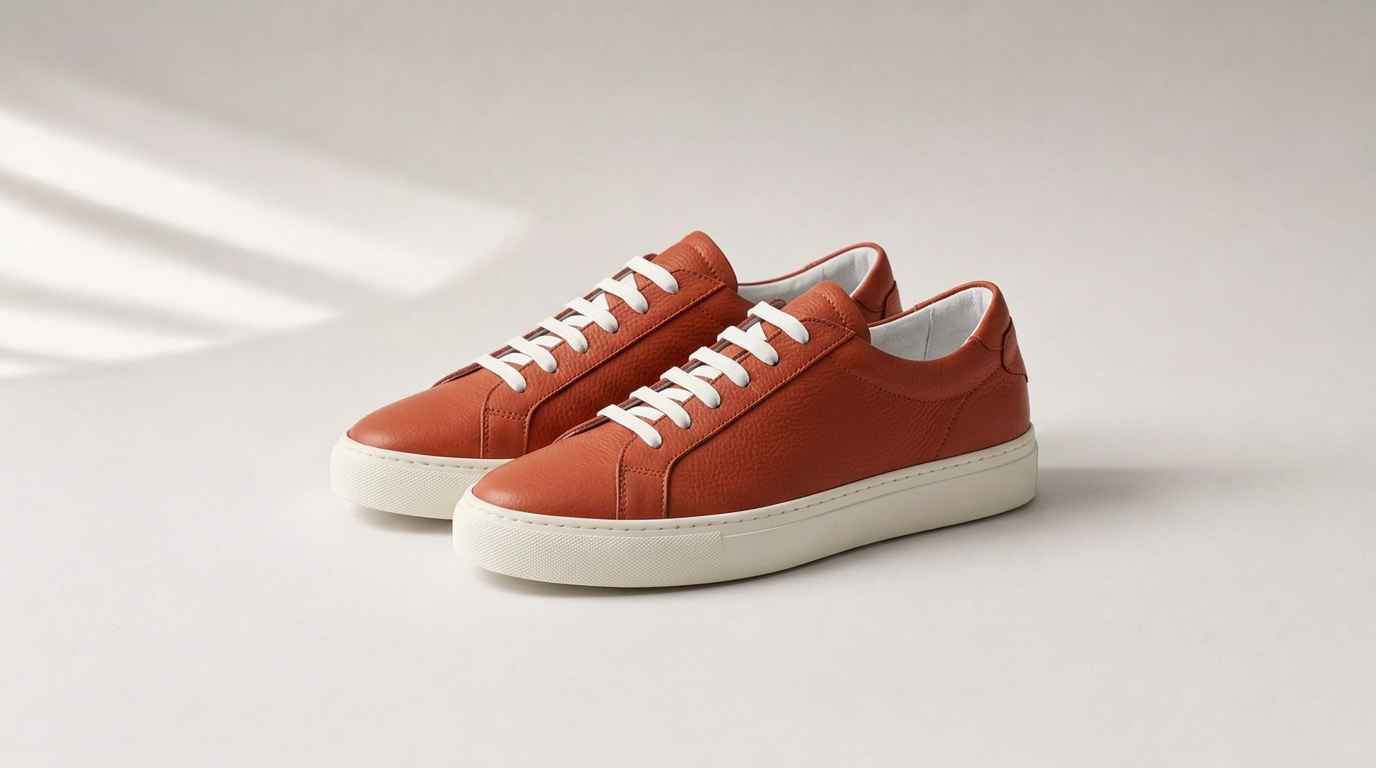
Создайте цветовые варианты одной модели без новой предметной съёмки. Полезно для каталога, маркетплейса и быстрого теста будущей коллекции.
Добавляйте, заменяйте и изменяйте предметы на фотографии по текстовому описанию.
Демонстрационный ограниченный режим ИИ-редактора
Редактируйте изображения так же просто, как пишете текст
Карточки товаров
Создайте цветовые варианты одной модели без новой предметной съёмки. Полезно для каталога, маркетплейса и быстрого теста будущей коллекции.
Недвижимость
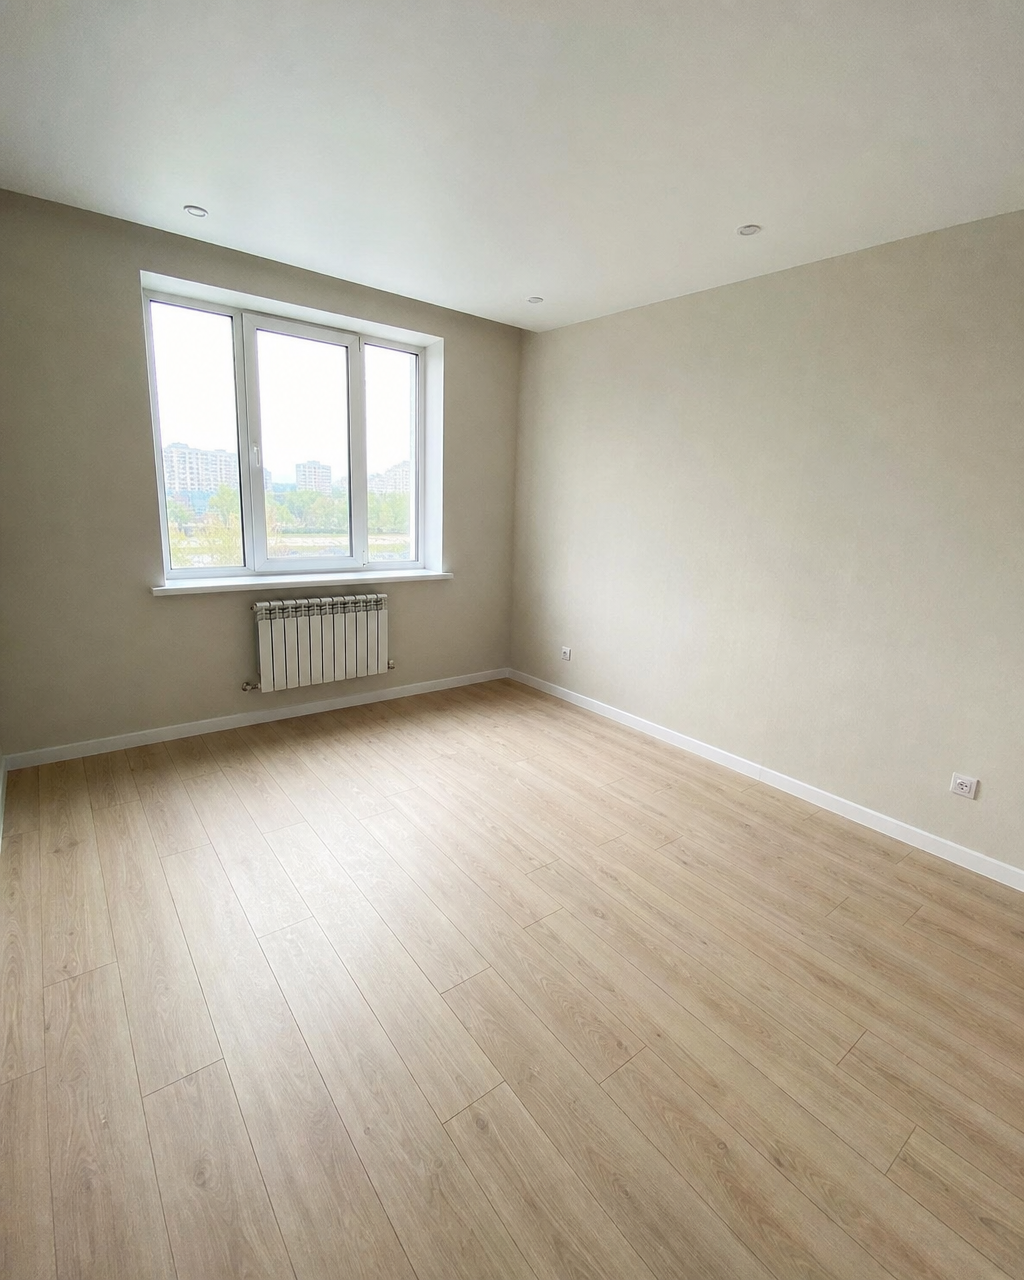
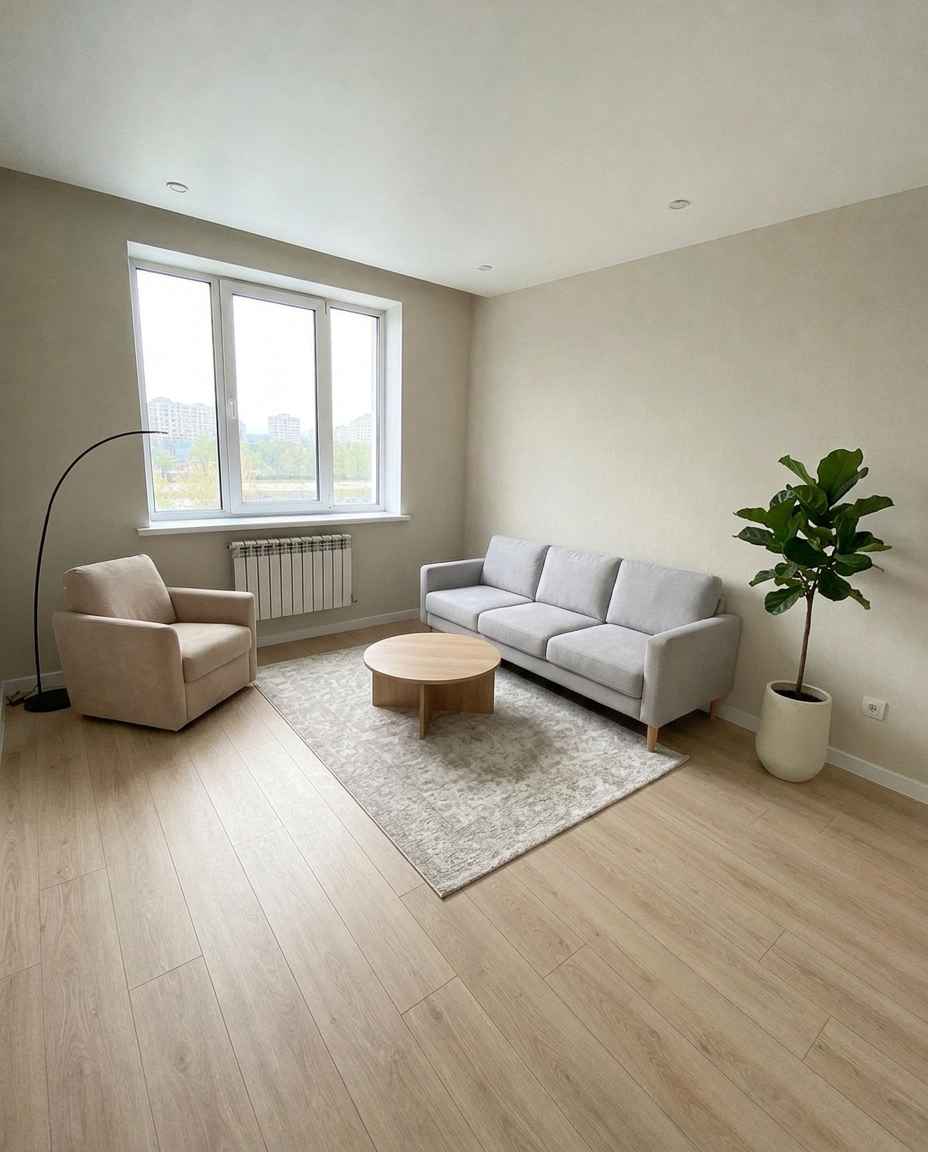
Добавьте в интерьер диван, свет и декор, чтобы помочь покупателю представить пространство. Это удобный черновик для объявления или согласования с дизайнером.
Магазины и вывески
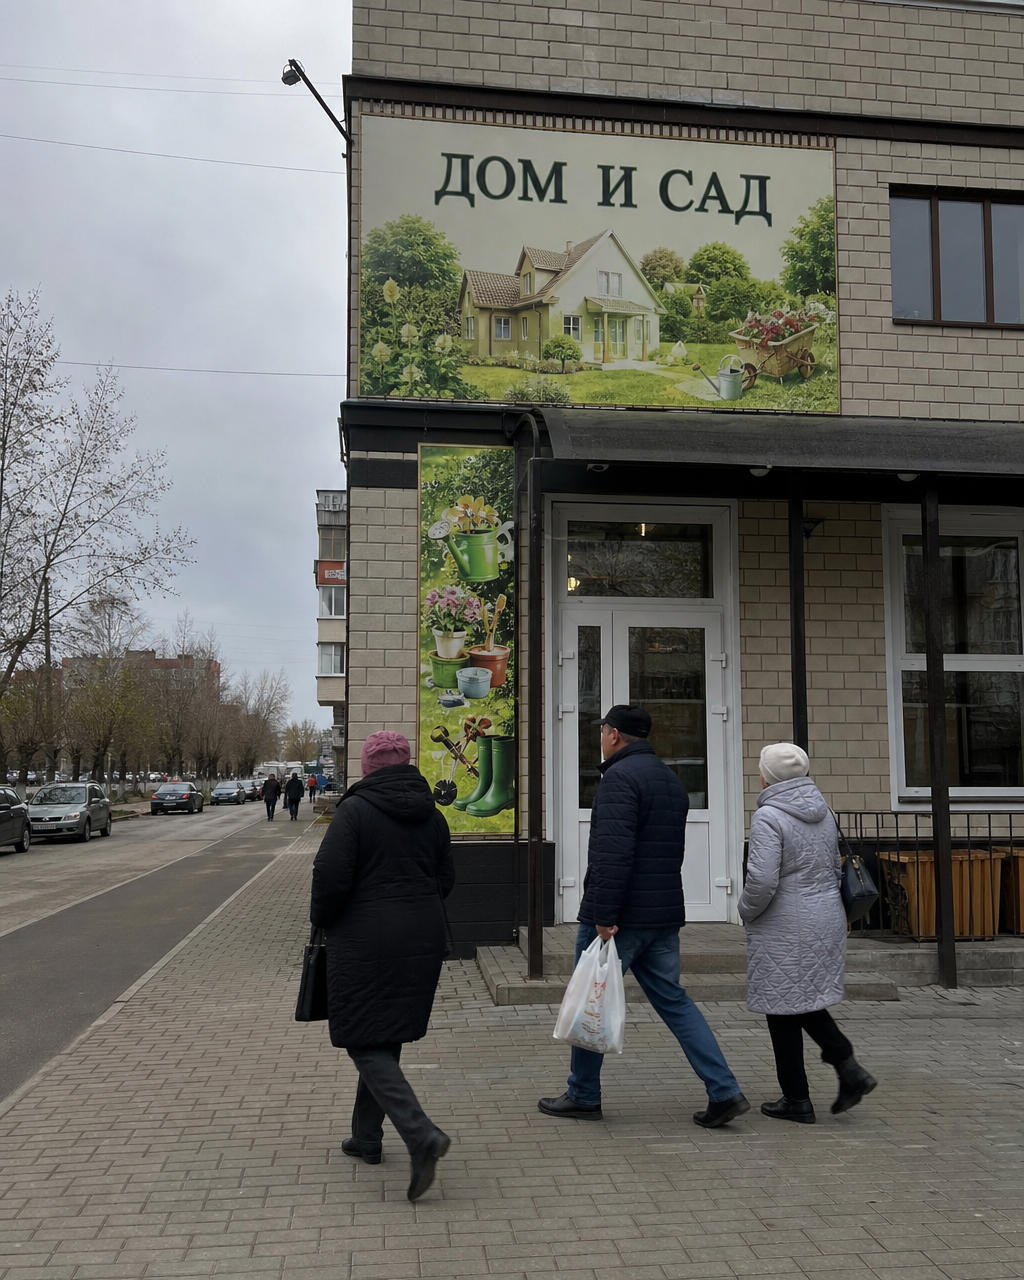 Люди закрывают рекламу
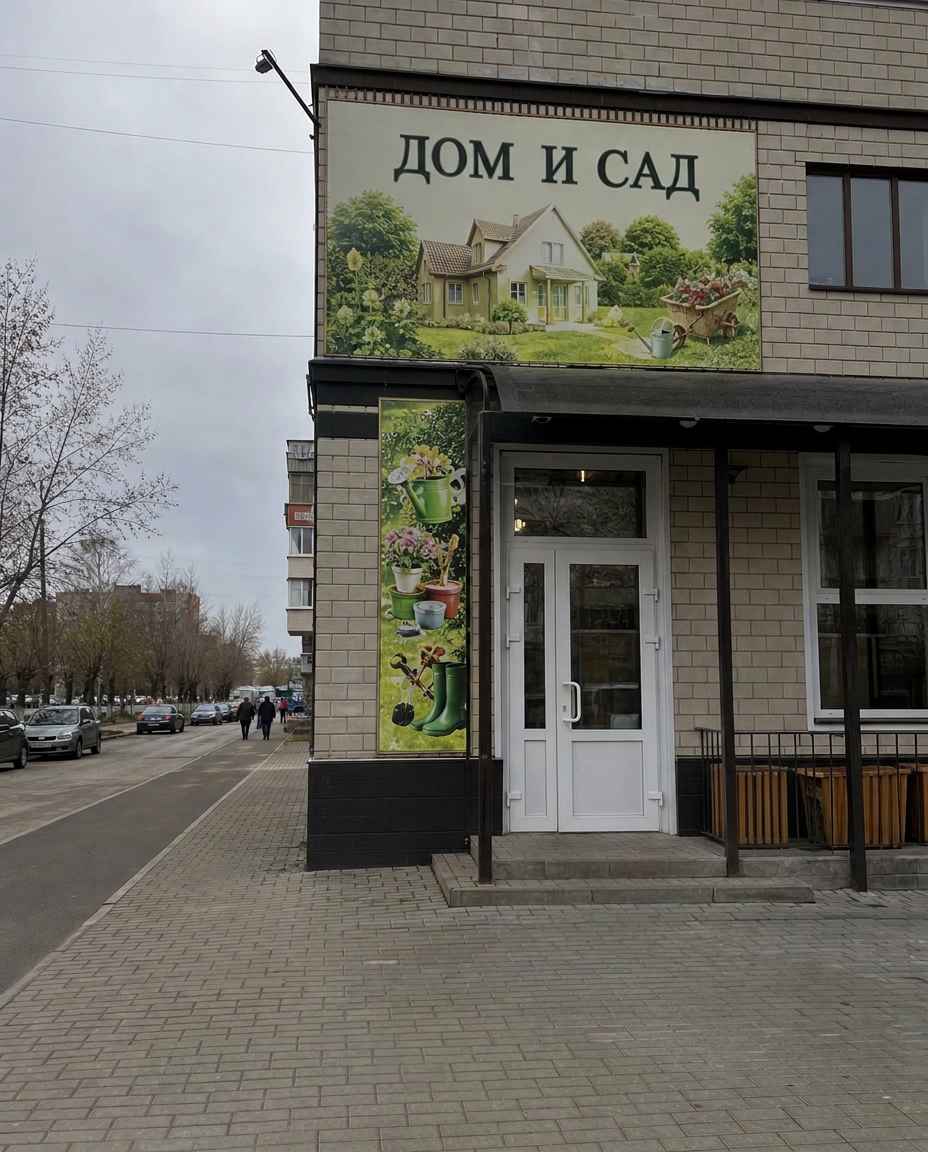 Вывеска полностью видна
Уберите случайных людей, которые закрывают вывеску или рекламный баннер у входа, и восстановите фасад так, чтобы магазин было легко рассмотреть на фотографии.
Изделия ручной работы
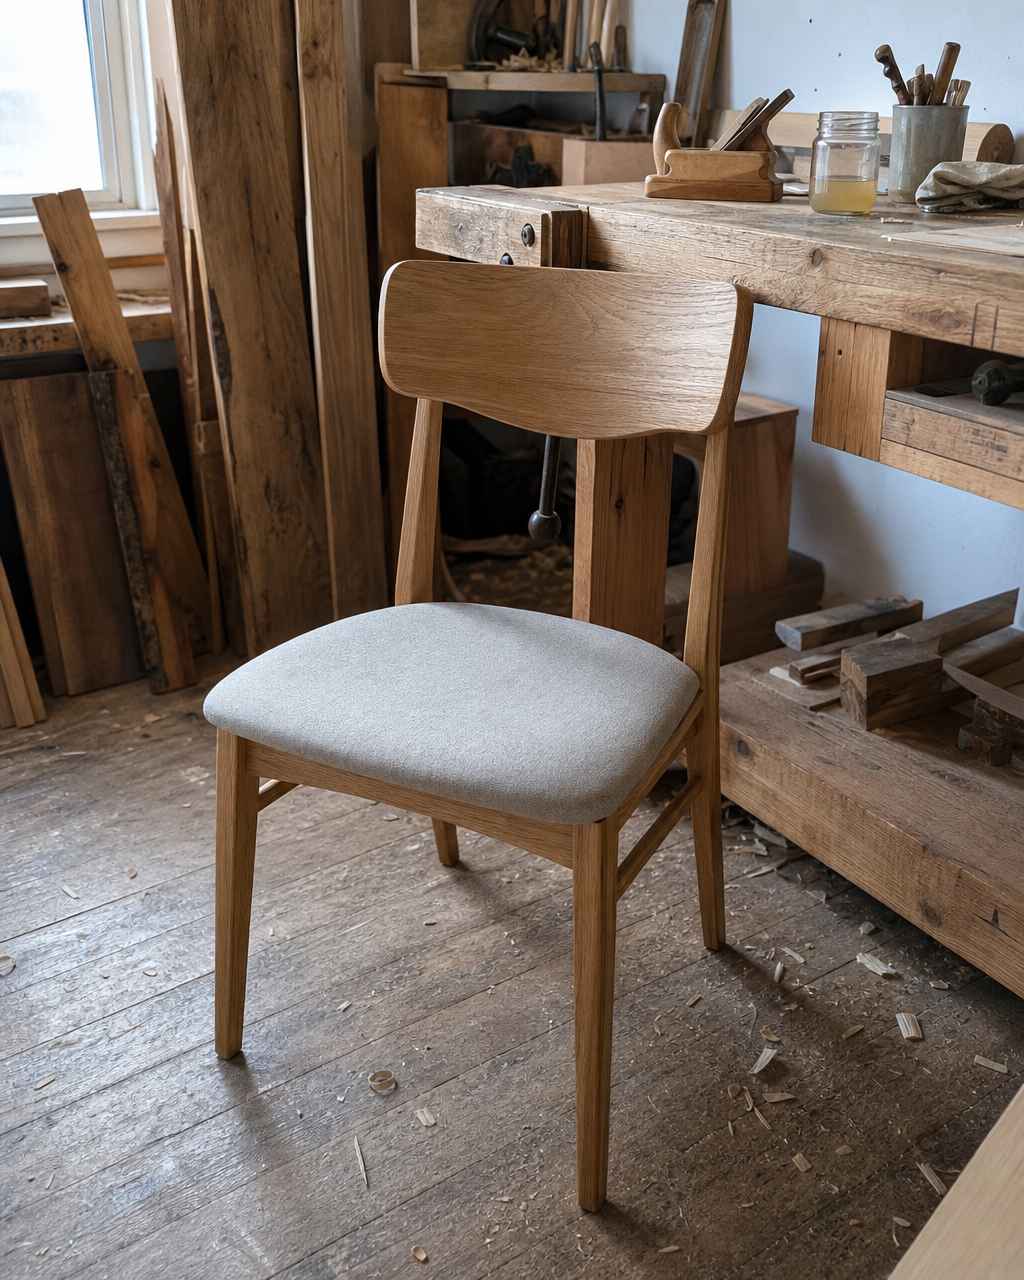 Фото из мастерской
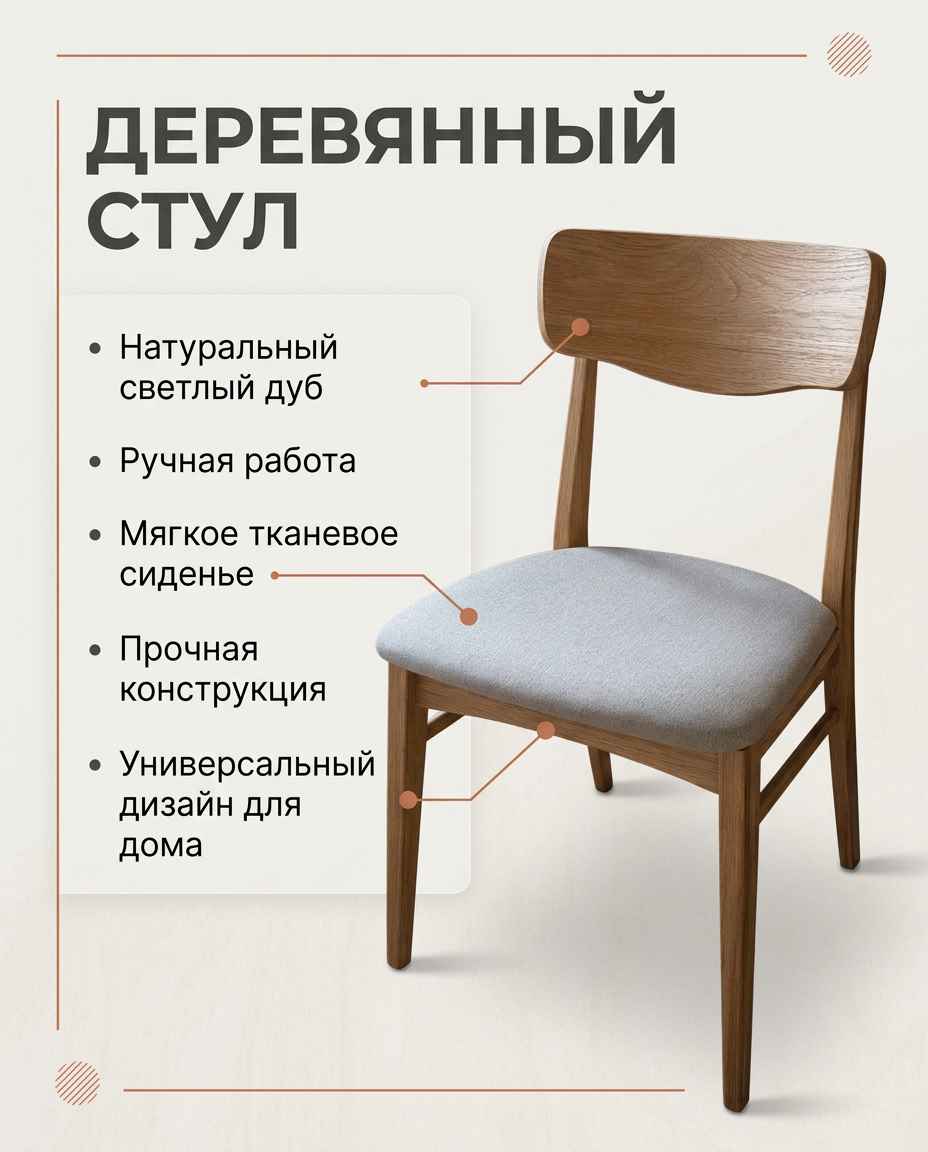 Карточка товара
Покажите, как обычная фотография рабочего процесса превращается в аккуратную marketplace-карточку с понятными преимуществами изделия: материал, ручная работа и качество конструкции.
Аренда жилья
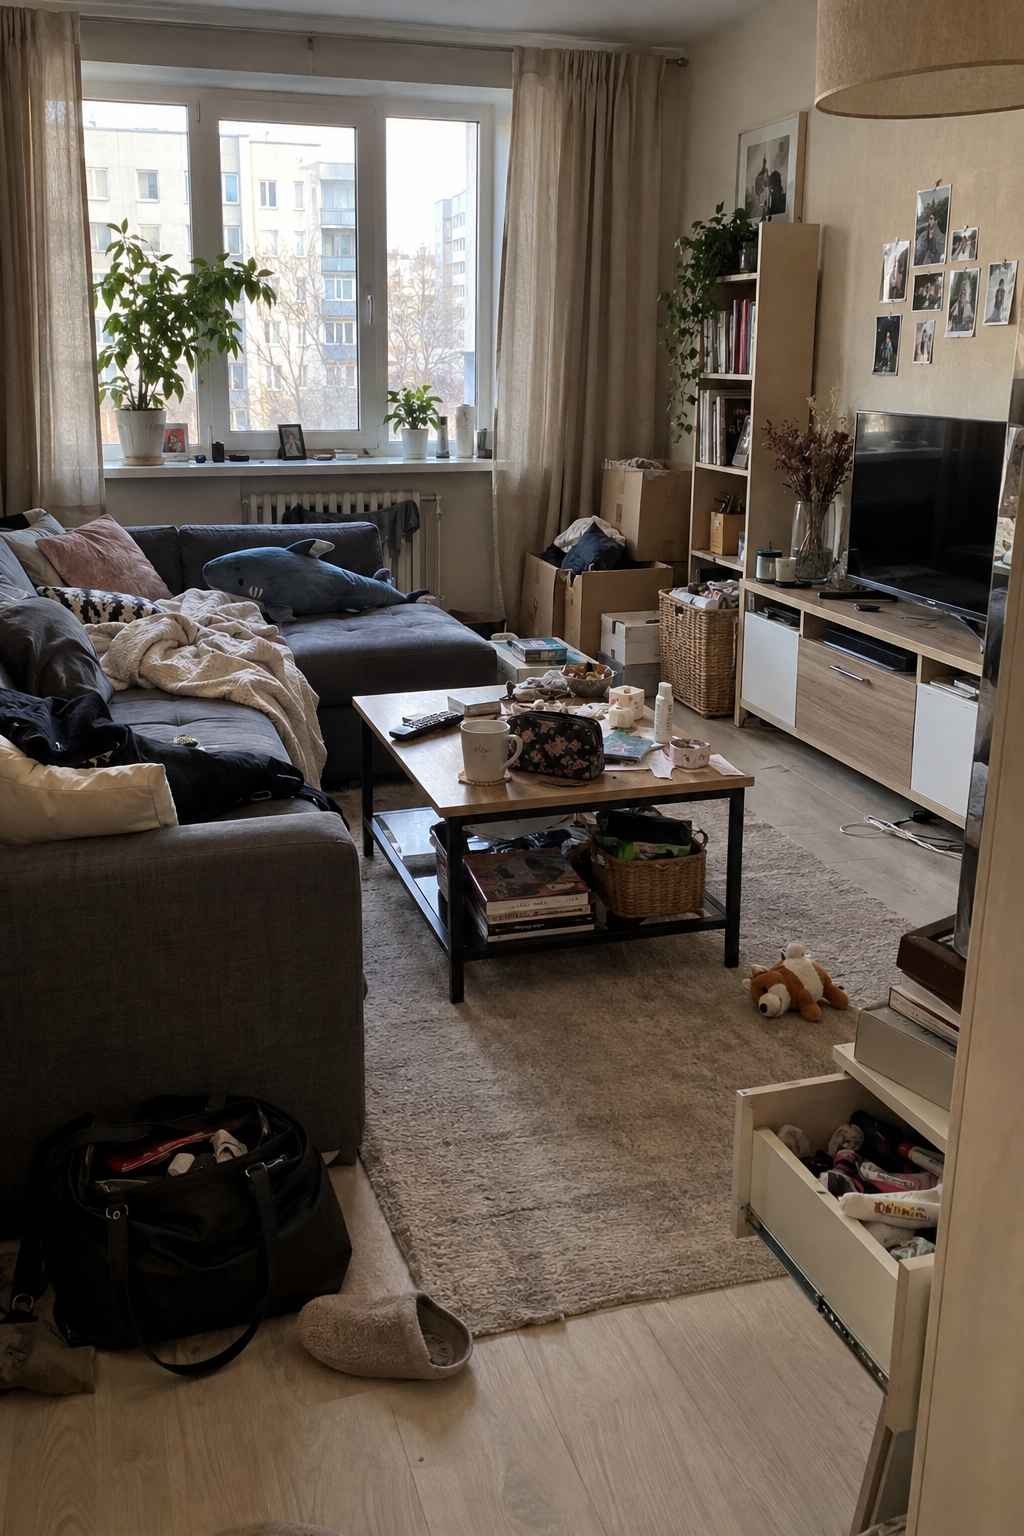 Квартира как есть
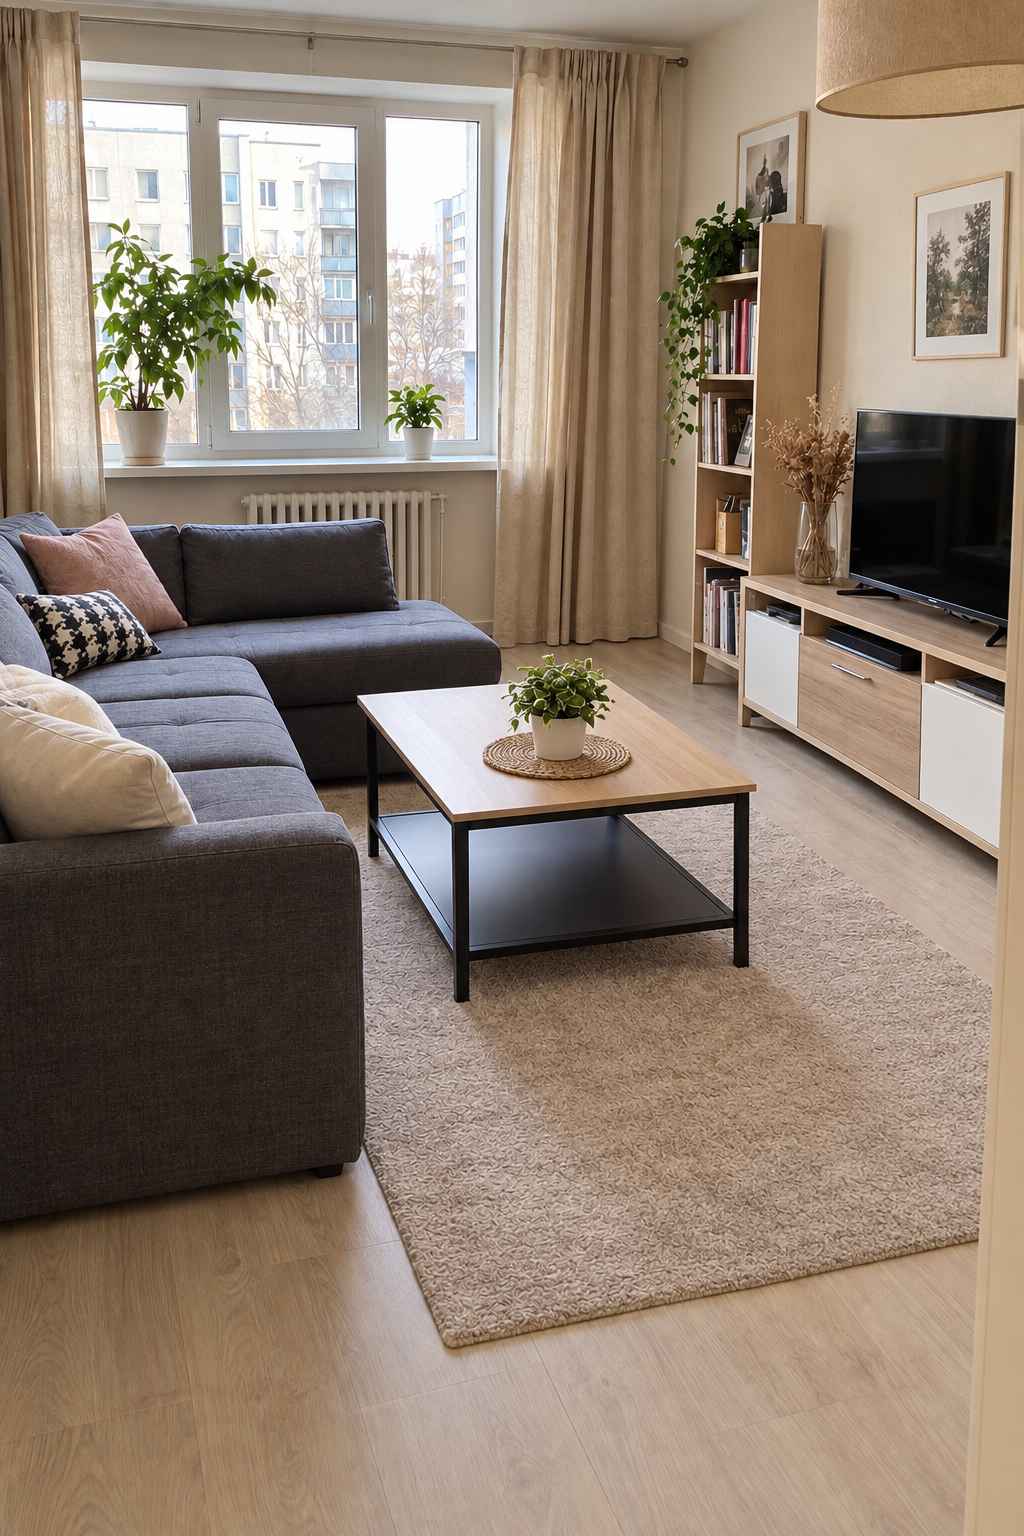 Фото для объявления
Сфотографируйте квартиру как есть, а затем приведите кадр в порядок перед публикацией: уберите личные вещи и бытовой беспорядок, сохранив настоящую планировку и атмосферу жилья.
Семейные фотографии
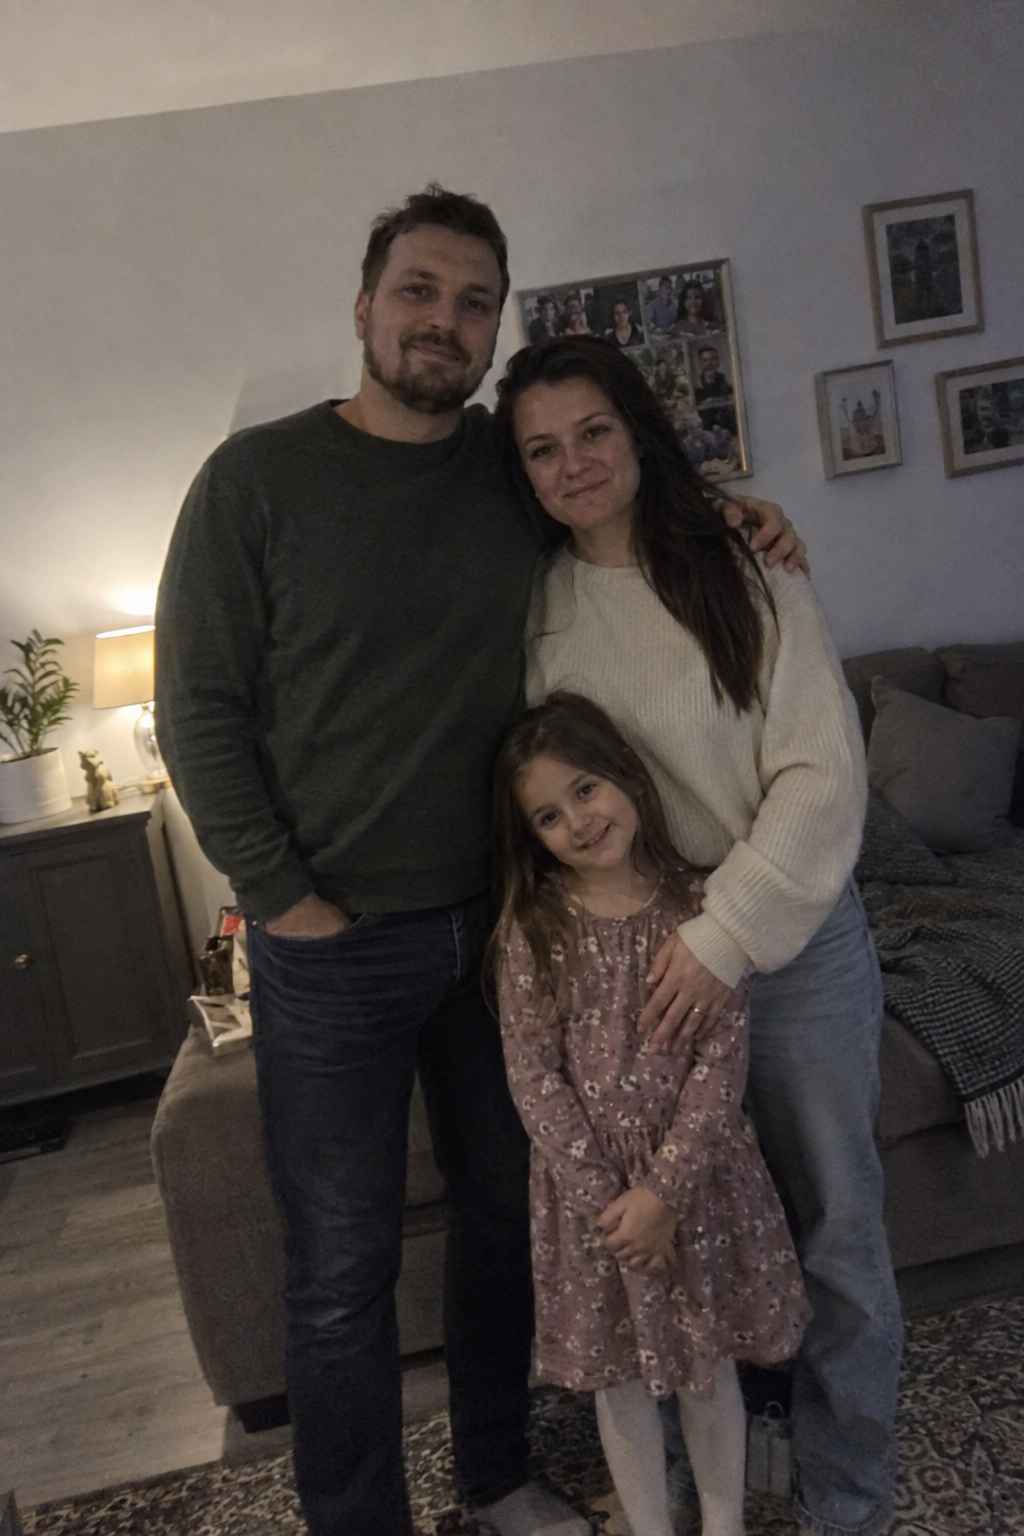 Фото как получилось
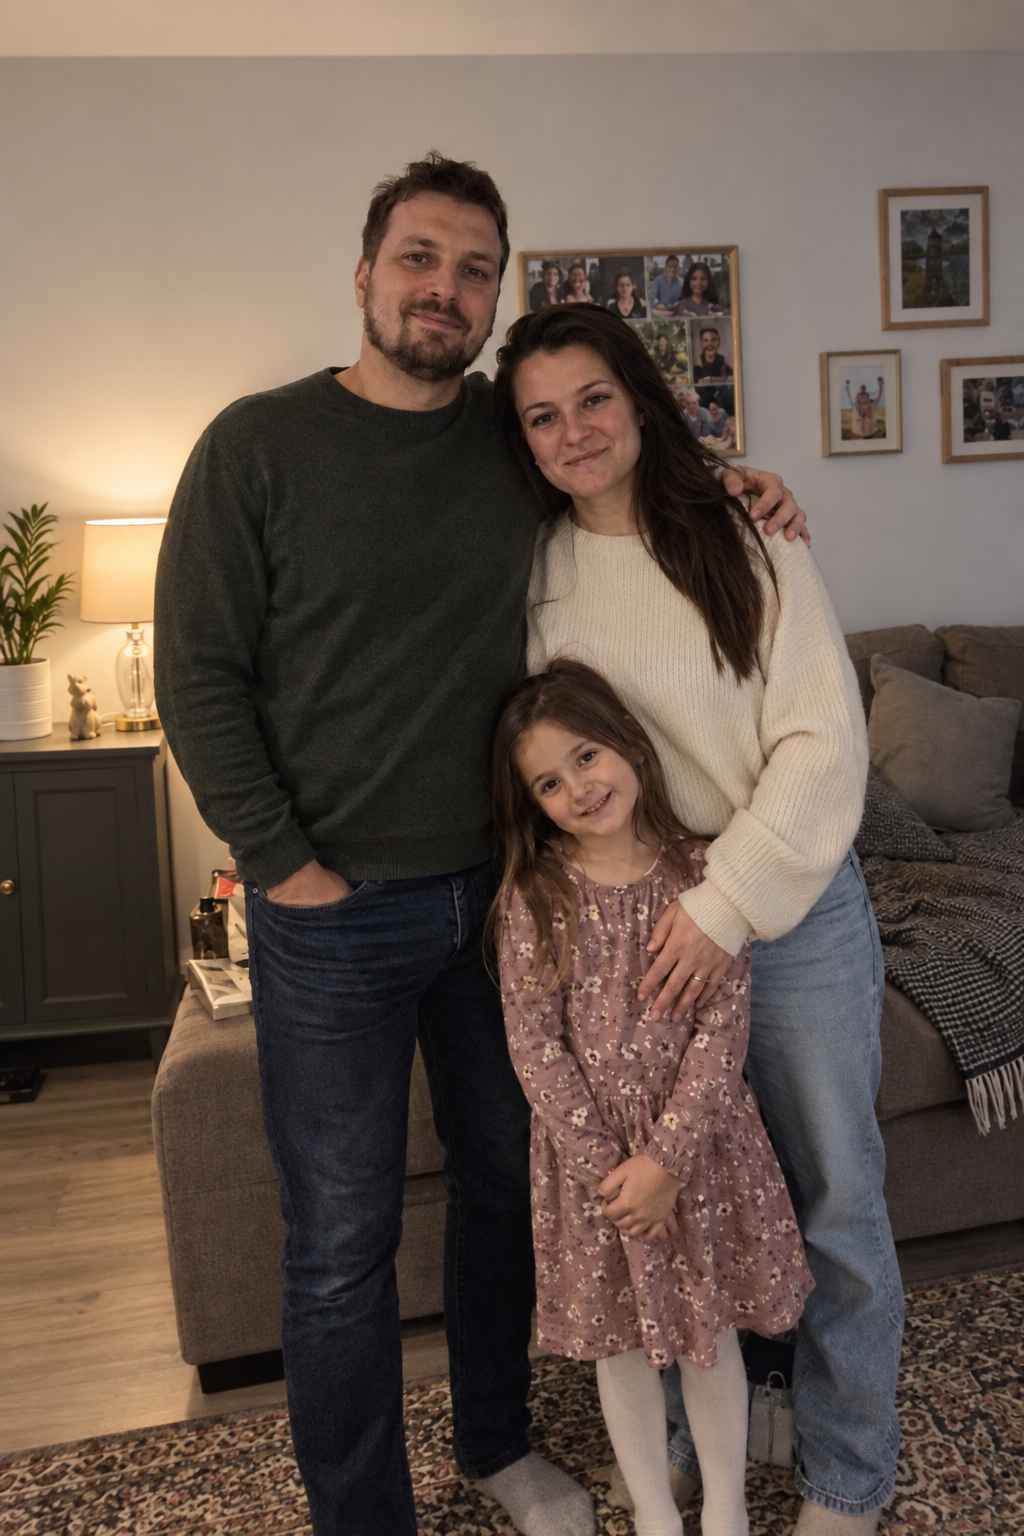 Семейный кадр улучшен
Даже случайное фото дома можно улучшить: выровнять слегка кривой ракурс, убрать лишнюю темноту и мягко восстановить детали, сохранив лица, эмоции и настоящую атмосферу семейного момента.
Инструкция
Загрузите фотографию в FinderAI и опишите, какой объект нужно добавить, заменить или изменить.
Формула хорошего запроса: назовите действие, объект и его место в кадре, затем добавьте ограничения. Например: «добавь чёрный металлический мангал слева от веранды, сохрани дом, перспективу, масштаб и солнечные тени».
Модели FinderAI. Для генерации и замены объектов можно сравнить Nano Banana, Nano Banana 2, Qwen Image, Grok Imagine Image и GPT Image 2. Если результат меняет лишние детали, уточните: «изменить только выделенную область, всё остальное оставить без изменений».
Работа с изображением
Генеративное редактирование позволяет менять отдельные части фотографии без пересъёмки: убрать случайный предмет, добавить нужный объект или заменить деталь, которая не подходит сцене. AI учитывает перспективу, масштаб, направление света и текстуру окружающих материалов. Поэтому задача звучит не как создание новой картинки с нуля, а как аккуратное изменение уже существующего кадра.
Самый предсказуемый запрос состоит из четырёх частей: действие, объект, расположение и ограничения. Например: «удали коробки на полу у дивана, восстанови рисунок ламината, стены и мебель не изменяй». Для добавления объекта полезно уточнить материал, размер и свет: «добавь небольшой чёрный мангал слева от веранды, поставь на траву, добавь мягкую тень вправо».
Для редактирования не существует одной универсальной модели: скорость, точность сохранения исходника, работа со светом, текстом и мелкими деталями различаются. В FinderAI можно сравнить несколько вариантов на одном изображении. Если модель изменила лишнюю часть кадра, сделайте запрос короче и строже: выделите нужную область, назовите только одно действие и отдельно перечислите элементы, которые должны остаться неизменными.
Опишите не только новый объект, но и сцену вокруг него: поверхность, время суток, направление света и расстояние до камеры. Тогда добавленный предмет будет выглядеть частью исходного снимка, а удалённый объект не оставит заметной пустоты.
У каждого производителя свой характер: Google делает ставку на скорость и устойчивость сцены, Qwen превращает изображение в точную информационную композицию, xAI работает как внимательный арт-директор, а OpenAI соединяет смысл, текст и форму. Ниже — все 11 моделей, доступные в тарифах FinderAI, и короткий ориентир, какую из них выбрать для конкретной правки.
Скорость и сцена
Qwen
Текст и детали
xAI
Точная правка
OpenAI
Смысл и стиль
04.08.2025
Alibaba / Qwen
Модель, которая сделала читаемый текст и сложную типографику частью генерации: постеры, схемы, рекламные макеты и точечные изменения объектов.
26.08.2025
Первый быстрый визуальный редактор семейства Gemini: несколько референсов, последовательные правки и сохранение ключевого объекта между вариантами.
20.11.2025
Старшая версия для сложной композиции, инфографики и точного исполнения многочастной инструкции, когда исходную сцену важно сохранить.
28.01.2026
xAI
Выразительный инструмент xAI для визуальных концепций, сцен и итераций, где текстовый замысел должен быстро превратиться в новый кадр.
26.02.2026
Быстрый рабочий цикл нового поколения Google: вариации, карточки товаров и регулярное редактирование без лишнего ожидания.
21.04.2026
OpenAI
Универсальная модель для текста внутри изображения, постеров, инфографики, продуктовых концептов и содержательных правок исходника.
30.06.2026
В тарифах FinderAI это Nano Banana 2 Lite, или Gemini 3.1 Flash-Lite Image: генерация примерно за четыре секунды, локальные правки и 14 соотношений сторон.
21.07.2026
Alibaba / Qwen
До 4,5 тыс. токенов инструкции, 12 языков, микротекст и богатые композиции. Модель превращает редактирование в точную работу с содержанием кадра.
07.08.2026
xAI
Редактирование как отдельная дисциплина: выделение области, удаление фона, smart resize и до пяти референсов в одном запросе.
08.09.2026
OpenAI / FAL
Компактная версия GPT Image 2.5, оптимизированная под скорость. OpenAI указывает качество примерно на уровне GPT Image 2, а FAL рекомендует Flare как стартовый вариант для большинства задач: генерации, редактирования, прозрачного фона и быстрых итераций.
08.09.2026
OpenAI / FAL
Самая мощная версия GPT Image 2.5 для случаев, где важнее качество, чем задержка. OpenAI выделяет точное редактирование и сохранение объекта, композиции и деталей; это выбор для сложных сцен, продукта, текста и финального изображения.
Nano Banana — коммерческое название Gemini 2.5 Flash Image, публично представленного Google 26 августа 2025 года. Google позиционирует модель как быстрый инструмент для генерации и редактирования изображений: она умеет работать с текстовым описанием, исходными картинками, несколькими референсами и последовательными правками. Для практических задач важны сохранение персонажа или предмета между вариантами, компоновка нескольких изображений, изменение отдельных объектов и создание читаемых надписей. В FinderAI модель подходит для быстрых итераций, предметных замен и недорогих концептов, когда важнее скорость проверки идеи, чем максимальная детализация.
Nano Banana Pro соответствует Gemini 3 Pro Image и был представлен Google 20 ноября 2025 года. Производитель описывает его как более сильный вариант для сложных композиций, точного следования инструкции и визуального результата с большим количеством деталей. Модель рассчитана на работу с текстом внутри изображения, схемами, инфографикой, предметными сценами и несколькими условиями в одном запросе. В редактировании она полезна, когда требуется сохранить исходную сцену, но аккуратно поменять объект, надпись, освещение или композиционный акцент. В тарифах FinderAI это выбор для задач, где качество и контроль важнее минимальной стоимости.
Nano Banana 2 заявлен как Gemini 3.1 Flash Image и публично появился 26 февраля 2026 года. По позиционированию Google это более быстрый вариант нового поколения для частых генераций, вариаций и редактирования. Модель рассчитана на короткий цикл «запрос — проверка — уточнение», поэтому особенно уместна для серийных визуалов, карточек товаров, контентных эскизов и массового перебора идей. Она сочетает способность понимать сцену и исходное изображение с меньшей задержкой, чем более тяжёлые модели. На странице тарифов её разумно выбирать для регулярной работы, когда нужна заметная детализация без максимального уровня цены.
В тарифах FinderAI это имя соответствует новой быстрой ветке Google: в публичных материалах Google Cloud она называется Nano Banana 2 Lite, или Gemini 3.1 Flash-Lite Image. Модель стала доступна в конце июня 2026 года и рассчитана на высокую частоту итераций: Google заявляет генерацию примерно за четыре секунды, низкую задержку, локальные правки, 14 соотношений сторон и работу с текстом и изображением в одном запросе. Для объекта на фото это практичный рабочий инструмент: поменять цвет, убрать лишнюю деталь, быстро проверить расстановку мебели или сделать серию вариантов. Для 2K/4K и особенно сложной типографики лучше перейти к старшим моделям.
Qwen Image был представлен командой Qwen 4 августа 2025 года как 20-миллиардная MMDiT-модель для генерации изображений. Главный акцент производителя — нативный рендеринг сложного текста: многострочные блоки, абзацы, китайские и английские надписи, постеры, схемы и слайды. Qwen также заявляет сильную работу с широким диапазоном художественных стилей и точное редактирование. В официальном обзоре перечислены перенос стиля, добавление и удаление объектов, улучшение деталей, изменение текста и позы персонажа. В FinderAI модель особенно полезна для плакатов, рекламных макетов и сцен, где важна читаемая типографика.
Qwen-Image-3.0 представлен Qwen 21 июля 2026 года как переход от просто красивой картинки к полезному производственному макету. В заявлении команды — до 4,5 тыс. токенов инструкции, сложные многочастные композиции, читаемый текст размером около 10 пикселей, 12 языков, интерфейсы и глубокая работа с контекстом. Особенно выразительно модель ведёт себя в редактировании: восстанавливает повреждённую живопись, добавляет аннотации на страницу, сохраняет фактуру и превращает исходную фотографию в информативную схему. Это сильный кандидат для вывесок, каталогов, планировок, карточек товара и сцен, где объект должен не просто появиться, а убедительно встроиться в смысл кадра.
xAI представила Grok Imagine API 28 января 2026 года как набор инструментов для генерации и редактирования визуального контента. В официальном описании акцент сделан на text-to-video и image-to-video, но платформа также используется для создания и изменения изображений через партнёрские каталоги. xAI заявляет сильное следование инструкции, быстрые итерации, работу с объектами, сценой, стилем и движением. Для задач FinderAI это означает удобный вариант для визуальных концепций, вариаций кадра и выразительных сцен. При редактировании полезно явно указывать, что именно заменить или удалить, а какие части исходника сохранить.
Imagine Image 2.0 вышел у xAI 7 августа 2026 года и стал доступен в API под именем grok-imagine-image-2.0. xAI строит модель вокруг идеи изображений для настоящей работы: она лучше удерживает исходные детали, понимает плотную типографику и относится к редактированию как к отдельной дисциплине. В наборе — выделение области, удаление фона, smart resize с достраиванием кадра и до пяти референсов за один запрос. Для редактора объектов это почти готовая ретушёрская панель: можно заменить предмет, не трогая остальную сцену, подготовить вертикальный баннер из горизонтального фото или собрать продуктовый кадр из нескольких источников.
GPT Image 2.0 представлен OpenAI 21 апреля 2026 года. В официальном материале компания подчёркивает более точную генерацию, улучшенную работу с многоязычным текстом, широкий диапазон визуальных стилей и способность превращать исследование или исходные материалы в готовые визуальные объекты. OpenAI также показывает применение модели для постеров, рекламных макетов, комиксов, инфографики, продуктовых концептов и редактирования. Для FinderAI это универсальный вариант, когда в одном запросе нужно совместить смысловую точность, текст, композицию и визуальный стиль. При замене объектов полезно отдельно перечислять неизменяемые детали сцены.
GPT Image 2.5 Flare доступен в тарифах FinderAI как вариант поколения GPT Image 2.5, ориентированный на более быстрый рабочий цикл. В текущей таблице тарифов и ссылке FAL он представлен отдельным маршрутом text-to-image; отдельный независимый пресс-релиз OpenAI с описанием именно названия Flare не найден. Поэтому корректно говорить о назначении маршрута, а не приписывать ему неподтверждённые технические рекорды. На практике Flare логично использовать для быстрых черновиков, вариаций и проверки промптов, когда скорость важнее максимального качества. Финальный вариант можно сравнить с Sunburst или GPT Image 2.0.
GPT Image 2.5 Sunburst также доступен в FinderAI отдельным маршрутом FAL для генерации изображений с несколькими уровнями качества и разрешения. Публичный материал OpenAI, подтверждающий точную дату и самостоятельное позиционирование названия Sunburst, не найден; поэтому не называем его отдельным официальным релизом без оговорки. В рабочем сценарии Sunburst стоит проверять на детальных композициях, финальных визуалах и задачах, где важны естественный свет, точное исполнение инструкции и аккуратная работа с исходной сценой. Начинайте с базового качества, а повышенные уровни выбирайте только когда разница заметна в результате.
Источники: Google Cloud, Qwen Image 3.0, Qwen Image, xAI Imagine Image 2.0, OpenAI Images 2.0 и FAL GPT Image 2.5.