Выбор модели для генерации изображений редко сводится к вопросу «какая нейросеть лучше». Для пользователя, который ищет нейросеть для картинок, важен не рейтинг сам по себе, а соответствие результата задаче. Один и тот же запрос может требовать разного инструмента: рекламный макет с читаемым текстом, иллюстрация по референсу, точное редактирование фотографии, быстрый черновик или локальный запуск без передачи данных внешнему сервису. Поэтому сравнивать модели полезнее не по громкости названия, а по тому, какую часть рабочего процесса они выполняют надёжнее.
В этой статье разберём GPT Image и семейство DALL·E, а базовые понятия из предыдущего материала о том, как нейросеть создаёт изображение помогут читать технические различия без лишней терминологии. Далее рассмотрим Stable Diffusion, FLUX, Qwen Image, Nano Banana, Grok Imagine, Imagen, Kandinsky, YandexART, HunyuanImage, PixArt, Sana, CogView и менее известные модели. Отдельно посмотрим на diffusion, flow matching, DiT и мультимодальные архитектуры, чтобы понять, чем нейросеть для генерации изображений отличается от просто удобного интерфейса вокруг готовой модели. а затем переведём технические различия в практический выбор: текст, референс, редактирование, скорость, разрешение, лицензия и способ доступа.
Сначала определите задачу, а не название модели
Для одной задачи важнее точность надписи, для другой — сходство лица с исходной фотографией, для третьей — возможность много раз перерисовывать отдельный объект. Модель, которая красиво создаёт сцену с нуля, может оказаться неудобной для аккуратной замены фона. А открытая модель, которую можно запустить локально, потребует видеокарту, настройку окружения и отдельную проверку лицензии.
Перед сравнением задайте себе пять вопросов:
- Нужно создать изображение с нуля или изменить уже существующее?
- Есть ли референс, стиль, персонаж или композиция, которые необходимо сохранить?
- Должен ли текст на изображении быть читаемым и точным?
- Нужен быстрый результат в интерфейсе или контроль над моделью, LoRA, seed и параметрами?
- Можно ли передавать изображение во внешний закрытый сервис и разрешено ли коммерческое использование результата?
Такой порядок помогает не путать качество самой модели с качеством интерфейса, промпта, апскейлера или последующего редактора.
DALL·E и GPT Image: закрытая мультимодальная линия
DALL·E стал одним из самых известных названий в текстово-условной генерации, но в актуальном практическом выборе важно различать историческое семейство DALL·E и новые GPT Image. В документации OpenAI GPT Image описывается как модель для генерации и редактирования изображений, принимающая текстовые и визуальные входы. Это уже не только сценарий «написал промпт — получил картинку», а работа с референсом, изменениями и последовательным уточнением результата.
Сильная сторона GPT Image — мультимодальный диалог вокруг изображения. В этом сценарии нейросеть для создания картинок становится не отдельным генератором, а частью последовательного рабочего процесса. Пользователь может описать, что нужно сохранить, что заменить и какие детали проверить. Для задач с надписями и макетами это часто удобнее, чем управлять длинной цепочкой отдельных узлов. Официальное руководство по генерации изображений OpenAI отдельно описывает параметры размера, качества, формата и редактирования.
Ограничение закрытой модели — меньшая прозрачность внутреннего конвейера. Поэтому режим нейросеть для генерации изображений бесплатно нужно оценивать не только по наличию бесплатного входа, но и по доступным размерам, числу итераций и правам на результат. Пользователь не получает тот же уровень контроля над весами, scheduler или обучением адаптеров, который возможен в локальной экосистеме Stable Diffusion. Для FinderAI это означает практический выбор в пользу готового результата и редактирования, когда не требуется вручную собирать граф генерации.
Stable Diffusion: экосистема и контроль
Stable Diffusion — не одна неизменная модель, а большая линия моделей, инструментов и расширений. Её значение связано не только с качеством отдельных версий, но и с экосистемой: локальный запуск, ControlNet, LoRA, инпейтинг, аутпейтинг, кастомные checkpoint-файлы и графы ComfyUI. Официальные материалы Stability AI по Stable Diffusion 3.5 подчёркивают настраиваемость моделей и условия лицензирования.
Если нужно построить повторяемый производственный процесс, Stable Diffusion часто выбирают именно за управляемость. Можно фиксировать seed, разрешение, sampler, strength, контроль позы и структуру референса. Это особенно полезно для серийных персонажей, каталогов, концепт-арта и задач, где изображение должно проходить несколько итераций.
Цена контроля — сложность. Нужно понимать, какая версия checkpoint используется, какие VAE и LoRA совместимы, что делает ControlNet и какие ограничения накладывает конкретная лицензия. Слово «open» не означает автоматически «разрешено всё»: условия могут различаться между базовой моделью, производным checkpoint и сервисом, который предоставляет к ней доступ.
FLUX: flow matching и трансформерная генерация
FLUX от Black Forest Labs стал важным примером того, как текстово-изобразительная генерация смещается от привычного представления о U-Net к трансформерным архитектурам. В официальном репозитории FLUX представлены модели и код инференса для генерации и редактирования. В зависимости от версии условия доступа отличаются: отдельные варианты ориентированы на разработчиков, другие имеют коммерческие или некоммерческие ограничения.
Практически FLUX часто рассматривают, когда нужны сильная композиция, выразительный стиль, работа с текстовым описанием и более современная архитектура. При этом нельзя переносить свойства одной версии на всё семейство: FLUX.1 и FLUX.2, dev, schnell и коммерческие варианты имеют разные веса, скорости и лицензии.
Для пользователя важен не сам термин flow matching, а то, что модель может давать другую траекторию перехода от случайного состояния к изображению. В интерфейсе это проявляется не одной универсальной кнопкой «качество», а сочетанием модели, числа шагов, разрешения, референса и настроек сервиса.
Qwen Image: текст, редактирование и открытая модель
Qwen Image интересен сочетанием генерации и редактирования. В карточке Qwen-Image отдельно заявлены возможности работы с текстом внутри изображения, а Qwen-Image-Edit расширяет семейство задачами редактирования. Это делает модель заметной в сценариях, где нужно не только придумать сцену, но и сохранить часть исходного изображения.
Сильный текстовый рендеринг не следует понимать как гарантию безошибочного логотипа или многострочного макета. Надпись всё равно нужно проверять символ за символом, особенно если в ней есть кириллица, мелкий кегль, юридическая информация или несколько языков.
Открытая доступность Qwen Image может быть важна для исследователей и команд, которым нужен контроль над размещением модели. Но техническая возможность скачать веса не равна готовому локальному продукту: нужны вычислительные ресурсы, совместимые библиотеки, настройка памяти и проверка лицензии конкретной версии.
Nano Banana: генерация внутри мультимодального диалога
Nano Banana — название, которым Google обозначает нативные возможности генерации изображений в Gemini. В документации Gemini API описан разговорный сценарий: модель может работать с текстом и изображениями как с частью одного мультимодального контекста. Это удобно, когда пользователь не хочет каждый раз заново описывать всю сцену, а последовательно уточняет композицию.
Практическое преимущество такого подхода — работа с референсами и итерациями. Нейросеть для генерации изображений по фото должна учитывать уже существующую композицию, а не начинать с пустого пространства: можно показать исходную фотографию, попросить изменить одежду или фон, затем уточнить стиль и формат. можно показать исходную фотографию, попросить изменить одежду или фон, затем уточнить стиль и формат. Но итог зависит от конкретной версии Nano Banana, канала доступа и текущих ограничений API или интерфейса. Название само по себе не сообщает ни точное разрешение, ни коммерческие условия.
Grok Imagine: быстрый креативный сценарий
Grok Imagine — линия моделей xAI для генерации изображений, доступная через пользовательские продукты и API. На странице Grok Imagine Image описаны генерация, входное изображение и оплата операций в API. Отдельная публикация xAI о Imagine Image 2.0 показывает, что семейство продолжает обновляться.
Для выбора это означает следующее: Grok Imagine разумно рассматривать как закрытый быстрый инструмент для визуальных экспериментов и итераций, но не следует заранее приписывать ему свойства всех предыдущих версий. Если задача связана с коммерческим брендом, сначала проверьте правила использования изображений, доступность API и требования к входным референсам.
Imagen: качество Google и смена поколений
Imagen — семейство моделей Google DeepMind, исторически ориентированное на высокое качество текстово-изобразительной генерации. На странице Imagen актуальное поколение описывается как модель с фокусом на фотореализм, детализацию и скорость. При этом документация API предупреждает о переходе между поколениями: устаревающие endpoints необходимо проверять на дату использования, а не считать все версии взаимозаменяемыми.
Imagen стоит выбирать, когда важны готовое качество и интеграция в экосистему Google, а не локальный контроль над весами. Если модель вызывается через агрегатор, нужно уточнить, какая именно версия Imagen скрывается за названием, какие размеры доступны и поддерживается ли редактирование. Один и тот же бренд может обозначать разные API-модели в разные периоды.
Kandinsky и YandexART: российские модели
Kandinsky — семейство моделей, связанное с российской исследовательской и продуктовой экосистемой. Его полезно рассматривать как отдельное направление, а не как прямую замену любой западной модели: важны поддержка русского языка, доступность в российских интерфейсах, особенности стилистики и конкретная версия. Для новых поколений нужно смотреть первоисточник модели и условия платформы, потому что публикации и пользовательские сервисы могут описывать разные редакции.
YandexART — генеративная модель Яндекса, ориентированная на создание изображений по текстовому описанию и интеграцию в продукты экосистемы. При выборе следует отделять модель от оболочки: интерфейс может добавлять свои ограничения, фильтры, пресеты, размеры и правила использования результата. Это особенно важно, если изображение предназначено не для личного эксперимента, а для публикации или рекламы.
В FinderAI российские модели имеет смысл сравнивать не по принципу «отечественная против зарубежной», а по реальной задаче. Поэтому запросы вроде нейросеть для генерации изображений Шедеврум или нейросеть для генерации изображений Кандинский лучше рассматривать как практический сценарий выбора конкретной модели, а не как доказательство её универсального превосходства. как модель работает с русским текстом, насколько хорошо удерживает референс, какие форматы выдаёт и можно ли продолжить работу с результатом в редакторе. Актуальный состав доступных моделей необходимо проверять в текущем интерфейсе FinderAI: каталог и условия доступа могут обновляться.
HunyuanImage: большая мультимодальная архитектура
HunyuanImage от Tencent интересен тем, что развивается как мультимодальная система, а не только как узкий генератор по строке prompt. В официальном репозитории HunyuanImage-3.0 и карточке модели на Hugging Face можно проверить архитектуру, требования к запуску и условия распространения.
Большой размер модели не гарантирует, что она будет лучшим выбором для каждого пользователя. Для локального запуска решающими становятся память GPU, скорость загрузки, поддержка оптимизированных форматов и зрелость инструментов. Для облачного доступа важнее цена операции, latency, доступность региона и то, сохраняется ли мультимодальный контекст между итерациями.
PixArt, Sana, CogView и менее известные модели
PixArt, Sana и CogView показывают, что рынок не ограничивается несколькими широко известными брендами. PixArt исследует эффективную текстово-условную генерацию с трансформерным подходом; Sana делает акцент на эффективности и возможности работать с более компактными конфигурациями; CogView развивается как китайская линия text-to-image-моделей. Для технического сравнения полезно начинать с научных работ и карточек весов, а не с рейтинга в интерфейсе агрегатора.
К малоизвестным моделям стоит относиться не предвзято, но осторожно. Иногда именно такая нейросеть для генерации картинок лучше решает узкую задачу — например, стилизацию, персонажей, локальное редактирование или генерацию при ограниченной видеопамяти. Иногда нишевая модель лучше решает конкретную задачу — например, стилизацию, персонажей, локальное редактирование или генерацию при ограниченной видеопамяти. Однако нужно отдельно проверить дату релиза, качество документации, происхождение датасета, лицензирование, наличие поддержки и устойчивость результата на серии запросов.
В статье о моделях нельзя честно составить вечный рейтинг. Название, которое сегодня находится среди лидеров, завтра может уступить новой версии или оказаться недоступным в конкретной стране и интерфейсе. Поэтому сравнение должно фиксировать дату проверки и версию модели.
Diffusion, flow matching и DiT: что стоит за названиями
Diffusion-модели обучаются восстанавливать структуру из зашумленного состояния. При генерации система начинает с шума и постепенно движется к изображению, используя текстовое или визуальное условие. Это не означает, что каждая современная модель устроена одинаково: меняются пространство, расписание шагов, denoiser, текстовый энкодер и декодер.
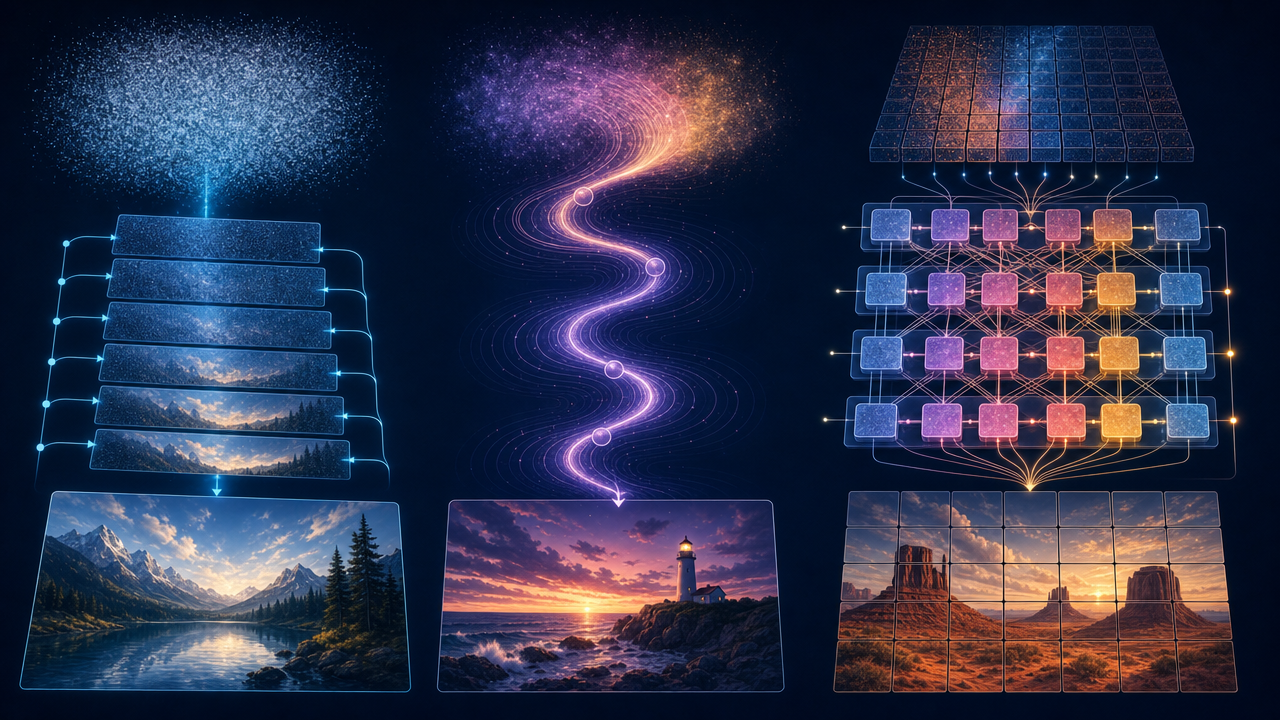
Flow matching описывает другой способ задать путь между начальным случайным состоянием и целевым распределением. Для пользователя это проявляется в скорости и характере траектории генерации, но сравнивать модели только по словам «diffusion» и «flow» неправильно. Качество зависит от данных, архитектуры, обучения, sampler или solver, разрешения и постобработки.
DiT — Diffusion Transformer, то есть трансформер, встроенный в diffusion-конвейер вместо или вместо части традиционного U-Net-подхода. Такой дизайн помогает масштабировать модель и работать с визуальными токенами или патчами, но не превращает её автоматически в мультимодальную модель. Мультимодальность означает способность связывать несколько типов входов — текст, изображение, видео или другие данные — в общей задаче.
Мультимодальные модели, такие как GPT Image, Nano Banana или HunyuanImage в соответствующих режимах, удобны для диалога и редактирования. Открытые diffusion- и DiT-модели чаще дают более глубокий контроль над процессом. Это два разных преимущества, а не шкала от «простого» к «продвинутому».
Текст, референс и редактирование: сравнивайте по операциям
Качество текста
Если изображение содержит вывеску, карточку товара, обложку или интерфейс, а пользователь выбирает нейросеть для картинок бесплатно, способность аккуратно рендерить текст становится отдельным критерием. Оценивайте не только наличие букв, но и точность написания, переносы, знаки препинания, кириллицу, разные размеры шрифта и стабильность при повторной генерации. Даже сильная модель может изменить одну букву или придумать правдоподобный, но несуществующий фрагмент.
Генерация по референсу
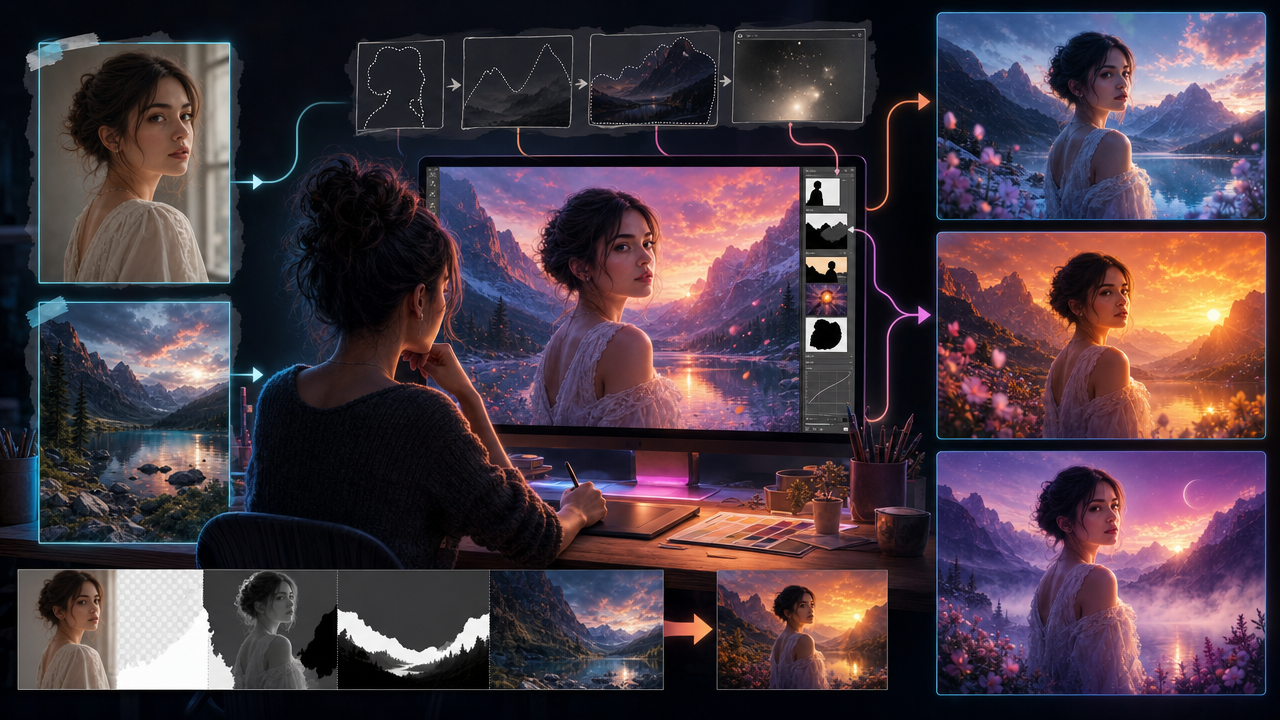
У референса есть несколько уровней сложности: сохранить общую композицию, повторить персонажа, изменить одежду, перенести стиль или объединить несколько изображений. Уточняйте, принимает ли модель изображения на вход, сколько референсов допускает, умеет ли выделять область и насколько точно сохраняет лицо, позу и пропорции.
Редактирование
Редактирование — это не просто ещё один prompt. Для замены объекта важны маска и границы; для удаления фона — края волос и полупрозрачные детали; для расширения кадра — продолжение перспективы и света; для замены текста — сохранение макета. У GPT Image, Qwen Image, Nano Banana и некоторых вариантов FLUX есть разные режимы редактирования, но переносить возможности одного сервиса на другое нельзя без проверки документации.
Скорость и разрешение
Скорость зависит от размера изображения, количества шагов, режима качества, очереди сервиса, аппаратного ускорения и постобработки. Быстрая модель может быть выгоднее для поиска композиции, после чего финальный вариант создаётся более медленным режимом. Поэтому корректнее разделять скорость черновика и скорость готового результата.
Разрешение тоже не равно детализации. Увеличение картинки апскейлером не восстановит автоматически неправильную руку, текст или перспективу. Сравнивайте нативный размер, доступные соотношения сторон, качество мелких деталей и возможность повторного редактирования после увеличения.
Открытые и закрытые модели: лицензия важнее ярлыка
Закрытая модель обычно проще для пользователя: не нужно устанавливать зависимости, выбирать checkpoint и следить за совместимостью компонентов. Но результат создаётся в инфраструктуре провайдера, а условия хранения входных изображений, использования результата и коммерческого применения нужно читать в правилах конкретного сервиса.
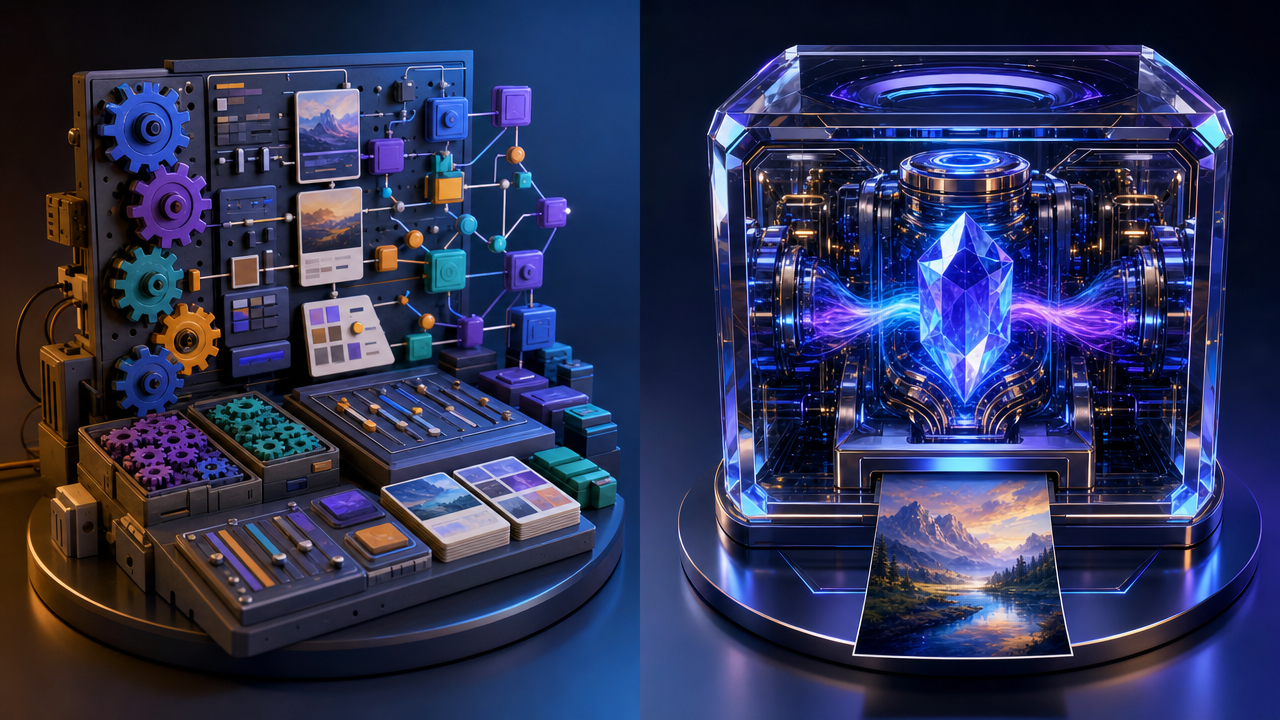
Открытая или open-weight модель даёт больше контроля, но не отменяет юридическую проверку. То же относится к сценарию нейросеть для создания картинок бесплатно: отсутствие оплаты за доступ не означает отсутствия условий лицензии или ограничений на коммерческое использование. Изучите лицензию базовых весов, ограничения на коммерческое применение, требования к атрибуции, правила для производных моделей и условия выбранного API. Например, в официальном репозитории FLUX прямо указаны разные режимы лицензирования для моделей, а у Stable Diffusion условия менялись между поколениями.
Отдельно проверяйте права на исходные изображения и датасеты, если команда дообучает модель. Лицензия веса не всегда отвечает на вопрос, можно ли использовать конкретный результат в рекламе, игре, упаковке или клиентском проекте. Если задача коммерческая, сохраните ссылку на условия и дату проверки.
Как выбирать модель в FinderAI
В FinderAI модель лучше выбирать от результата, который должен получить пользователь, а не от списка брендов. Для запроса «сделать изображение с нуля» достаточно сравнить композицию, стиль, текст и скорость. Для исходной фотографии важнее наличие надёжного режима редактирования и сохранение объекта. Для серии материалов нужны повторяемость, понятные размеры и возможность быстро исправлять отдельные детали.
Практический маршрут может выглядеть так:
- Сформулировать задачу: генерация, редактирование, референс, расширение кадра или удаление объекта.
- Выбрать две-три модели с разными сильными сторонами, а не запускать десять вариантов без критерия.
- Использовать один и тот же prompt, размер и референс, если интерфейс это позволяет.
- Сравнить текст, композицию, сходство, детали, скорость и число исправлений.
- Перед публикацией проверить лицензию, случайные логотипы, артефакты и фактические надписи.
В FinderAI доступность конкретных моделей и режимов нужно проверять в актуальном каталоге продукта. Интерфейс агрегатора может обновляться быстрее, чем обзоры и поисковые страницы, поэтому название модели, качество и условия не следует считать постоянными без текущей проверки.
Сравнить задачу и подобрать рабочий сценарий в FinderAI →
Короткий ориентир по выбору
- Нужно быстро получить готовый результат и редактировать его диалогом. Смотрите на GPT Image, Nano Banana, Grok Imagine и другие закрытые мультимодальные инструменты.
- Нужен контроль, локальный запуск и расширения. Изучайте Stable Diffusion, совместимые DiT-модели и экосистему FLUX.
- Важен текст внутри изображения. Сравнивайте GPT Image, Qwen Image, Imagen и конкретные актуальные версии, проверяя кириллицу на реальном примере.
- Нужно сохранить референс. Ищите подтверждённый image input, mask, inpainting и subject consistency, а не только обещание «работает с фото».
- Важна российская доступность. Проверяйте Kandinsky, YandexART и актуальные модели в интерфейсе FinderAI, не делая вывод о качестве только по происхождению.
- Нужна исследовательская или локальная работа. Смотрите на Qwen Image, HunyuanImage, PixArt, Sana, CogView и другие open-weight-модели, но учитывайте GPU, документацию и лицензию.
Что обязательно проверить перед использованием
Ни одна таблица не заменяет контроль на собственном примере. Возьмите один prompt, один референс и несколько типичных для проекта задач: лицо, руки, логотип, мелкий текст, сложная перспектива, прозрачный объект. Сравните не только лучший кадр, но и количество неудачных попыток, скорость исправления и возможность повторить результат через неделю.
Не публикуйте изображение только потому, что оно выглядит убедительно. Проверьте текст вручную, отсутствие чужих логотипов, правдоподобие геометрии, права на референс и условия использования модели. Для рекламы и коммерческих материалов дополнительно сохраните дату проверки лицензии и версию модели.
Техническое сравнение — это способ сузить выбор, а не доказать универсальное лидерство. Лучшей оказывается та модель, которая стабильнее решает именно вашу задачу в конкретном интерфейсе, бюджете, разрешении и правовом режиме.
Источники и дата проверки
Материал подготовлен с проверкой официальных страниц и карточек моделей 18 сентября 2026 года. Модели, версии, API и лицензии быстро меняются, поэтому перед коммерческим использованием повторно откройте первоисточник.
- OpenAI: GPT Image 2 и руководство по генерации изображений.
- Black Forest Labs: официальный репозиторий FLUX.
- Stability AI: Stable Diffusion 3.5.
- Qwen-Image и Qwen-Image-Edit на Hugging Face.
- Google Gemini API: генерация изображений Nano Banana.
- xAI: Grok Imagine Image 2.0 и документация API.
- Google DeepMind: Imagen.
- Tencent: HunyuanImage-3.0 и карточка модели.
- PixArt-α, Sana и CogView2.