Короткий ответ: нейросеть не рисует картинку как человек
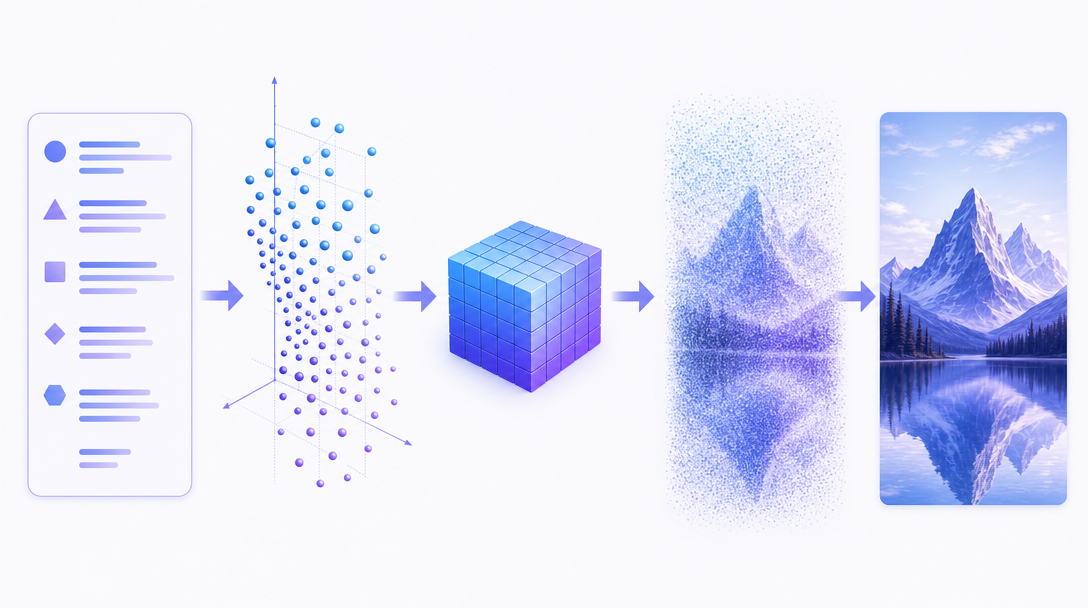
Когда пользователь пишет «ночной город под дождём, снятый на плёнку», модель не берёт кисть, не ищет готовую фотографию и не раскладывает сцену по слоям так, как это сделал бы дизайнер. Она переводит текст в числовые представления, сопоставляет его с выученными закономерностями и строит результат в пространстве, где изображение можно постепенно уточнять.
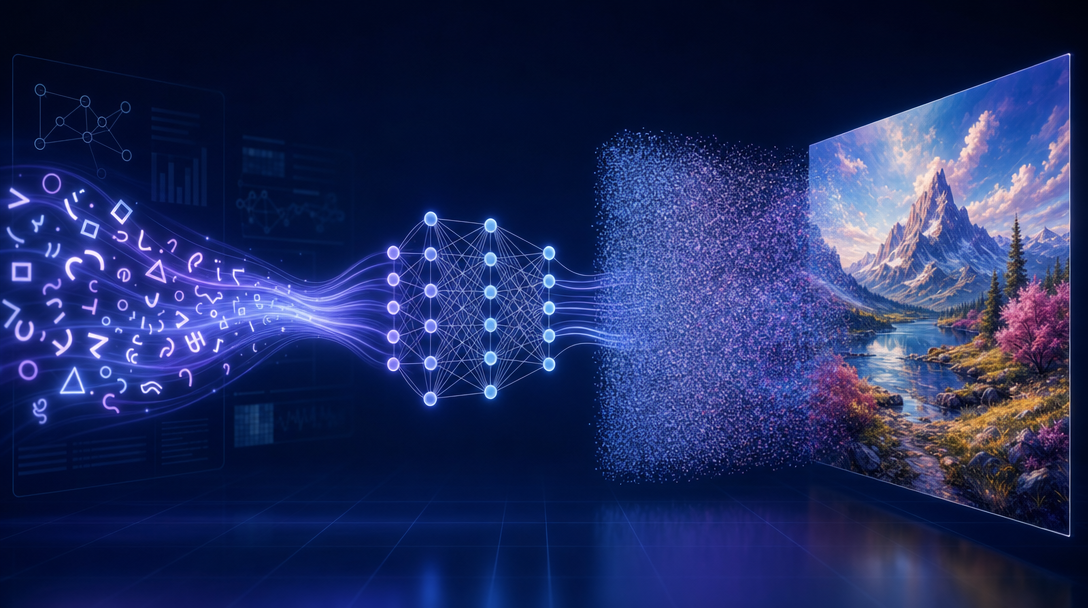
В современных генераторах этот процесс чаще всего выглядит как движение от случайности к структуре. Модель начинает с шума, на каждом шаге оценивает, какая часть случайности не соответствует условию, и убирает её. В конце декодер переводит внутреннее представление в обычные пиксели, которые можно сохранить как PNG или JPEG.
Так работает современная нейросеть для генерации изображений: она не рисует объект вручную, а вычисляет наиболее согласованное продолжение для заданного условия. Поэтому нейросеть для картинок может создавать очень разные результаты из одного описания — итог зависит от случайного начального состояния, модели и параметров генерации.
Это упрощённая схема. Разные семейства моделей работают по-разному: одни используют диффузию в непрерывном латентном пространстве, другие — последовательное предсказание дискретных визуальных токенов, третьи объединяют генерацию с мультимодальным рассуждением. Но общий принцип полезен: картинка для модели — не «фотография внутри компьютера», а набор числовых состояний.
Пиксели, токены, векторы и латенты: четыре разных уровня
Слова «токен», «вектор», «латент» и «пиксель» часто используют рядом, хотя они обозначают разные вещи. Если их смешать, описание генерации быстро превращается в набор красивых, но неточных метафор.
- Пиксель — элемент изображения в готовом файле. У него есть координата и значения цвета, например три канала RGB. Пиксели находятся ближе всего к тому, что видит человек.
- Токен — отдельная единица последовательности, с которой работает модель. В тексте токеном может быть слово, часть слова, знак препинания или фрагмент Unicode. В изображении токеном иногда называют дискретный код визуального фрагмента.
- Вектор — упорядоченный набор чисел. Токен обычно превращается в векторное embedding-представление, чтобы модель могла сравнивать его с другими представлениями и учитывать контекст.
- Латент — внутреннее представление изображения или другого объекта в сжатом пространстве. Оно не обязано быть читаемым человеком и не является просто уменьшенной копией картинки.
Простая аналогия: пиксели похожи на отдельные точки печати, токены — на элементы записи, векторы — на координаты в математическом пространстве, а латент — на сжатый рабочий чертёж. Аналогия помогает объяснить порядок уровней, но не описывает конкретную архитектуру каждой модели.
Как текст превращается в числа
Первый этап начинается с токенизатора. Он разбивает запрос на части, которые есть в его словаре. Фраза «красный воздушный шар» может превратиться в несколько токенов; точное разбиение зависит от языка, словаря и архитектуры. Токен — это не смысл и не картинка, а идентификатор элемента последовательности.
Затем идентификаторы проходят через текстовый энкодер. Он преобразует их в векторы и учитывает соседние слова: «портрет девушки в красной куртке» и «красный портрет девушки в куртке» содержат похожие элементы, но связи между ними могут быть разными. Энкодер формирует числовой контекст, который генератор использует как условие.
Для этого применяются разные языковые и мультимодальные компоненты. В классических системах текстовый энкодер мог быть отдельной моделью, обученной сопоставлять описания и изображения. В других архитектурах текст обрабатывается трансформером, который умеет учитывать отношения между токенами и передавать их в генеративный блок.
Даже нейросеть для создания картинок не получает от текста готовую инструкцию по пикселям: она извлекает из описания признаки, связи и вероятные визуальные решения. Поэтому режим нейросеть для генерации изображений бесплатно может дать качественный результат, но не отменяет ограничений конкретной модели и её контекста.
Важно не говорить, что модель «понимает» описание в человеческом смысле. Она выучивает статистические связи между последовательностями текста и визуальными признаками на данных обучения. Чем точнее в обучении связаны слова, композиции и изображения, тем устойчивее ассоциация — но это не гарантирует точного исполнения каждого отношения.
Как текст влияет на изображение
Одного текстового вектора недостаточно: генератору нужно использовать его во время построения картинки. В диффузионных архитектурах это часто происходит через cross-attention — механизм, который позволяет внутренним признакам изображения обращаться к частям текстового контекста. На разных слоях модель может извлекать информацию о предмете, стиле, цвете, пространственных отношениях и деталях.
Это не означает, что каждое слово получает отдельный «участок холста». Внимание распределяется по вычислениям и может меняться от шага к шагу. Общие слова влияют на композицию, конкретные — на локальные признаки, а некоторые детали могут потеряться, если они слабо представлены в данных или конфликтуют с остальными условиями.
Промпт — это не чертёж с гарантированными координатами. Это условие, которое меняет вероятности разных вариантов результата.
Как изображение превращается в шум
Чтобы научить модель обратному процессу, изображение сначала постепенно зашумляют. В исходной фотографии есть структура: контуры, цвета, поверхности и отношения между объектами. К ней добавляют случайный шум небольшими порциями. После многих шагов исходная структура становится почти неразличимой.
Этот этап называют forward process, или прямым процессом диффузии. В математической записи для каждого шага задаётся уровень шума, а расписание определяет, сколько сигнала изображения сохранить и сколько случайности добавить. Модель во время обучения получает зашумлённый пример, уровень шума и условие — например, текстовое описание.
Важная деталь: модель обычно не учится «запоминать путь от каждой конкретной фотографии». Она учится оценивать закономерность, по которой из текущего зашумлённого состояния можно восстановить более вероятное чистое состояние. Благодаря этому при генерации можно начать не с фотографии из обучающей выборки, а со случайного шума.
Как модель убирает шум
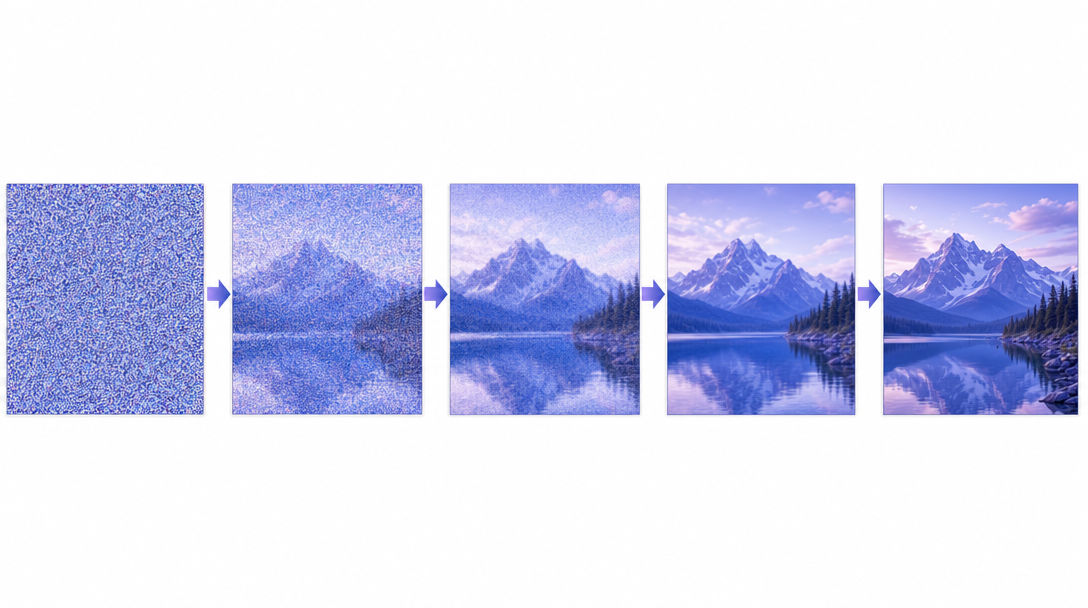
Обратный процесс называется denoising — удаление шума. На каждом шаге нейросеть получает текущий зашумлённый латент, текстовое условие и информацию о времени или уровне шума. Она оценивает, какую часть случайности нужно убрать или какое более чистое состояние следует получить дальше.
После предсказания применяется формула шага, а не простая операция «вычесть всё лишнее». Следующий латент немного ближе к структуре, которая согласуется с условием. Затем процедура повторяется. В начале шаги определяют крупную композицию, позже — контуры, текстуры и небольшие детали. Это полезная интуиция, но граница между этапами не универсальна и зависит от модели и sampler.
В результате получается траектория из нескольких промежуточных состояний. Если сохранить их, можно увидеть, как из облака случайных точек возникает объект, пейзаж или персонаж. На практике пользователю обычно показывают только финальный результат.
Diffusion, sampler и guidance
Diffusion
Diffusion — семейство вероятностных моделей, в которых прямой процесс постепенно разрушает данные шумом, а обученный обратный процесс восстанавливает структуру. Для генерации изображения модель стартует с шума и применяет обратные шаги. Диффузия не означает, что файл физически «растворяется» в облаке: это математическая схема преобразования представлений.
Sampler
Sampler — алгоритм, который превращает предсказания модели в последовательность шагов генерации. Он определяет, как обновлять текущее состояние, сколько шагов сделать и как проходить по траектории. Поэтому две системы с одной базовой моделью, но разными sampler и настройками, могут дать различный результат.
Число шагов не является универсальным показателем качества. Больше шагов может дать более долгую и иногда более устойчивую траекторию, но не исправляет слабое условие, плохой исходный референс или ограничение самой модели. Современные sampler позволяют получать результат быстрее, чем ранние прямолинейные схемы, но цена скорости зависит от архитектуры и задачи.
Guidance
Guidance — способ усилить влияние условия, например текста. В classifier-free guidance модель сравнивает предсказание с условием и без него, а затем увеличивает направление, связанное с запросом. При умеренном значении это может сделать изображение более соответствующим описанию. При слишком сильном guidance появляются перенасыщенные цвета, неестественные контуры и потеря разнообразия.
Настройку guidance нельзя трактовать как «чем больше, тем точнее». Это компромисс между следованием тексту и естественностью результата. В разных моделях одинаковое числовое значение не означает одинаковое поведение.
Почему диффузию часто запускают в латентном пространстве
Работать напрямую с пикселями дорого. Изображение 1024×1024 содержит больше миллиона позиций, и каждый шаг диффузии должен обрабатывать большой массив данных. Latent diffusion переносит основной процесс в сжатое представление. Энкодер уменьшает изображение до латента, диффузионная модель работает с ним, а декодер возвращает результат в пиксельное пространство.
Сжатие даёт выигрыш по вычислениям и позволяет моделировать более крупные изображения. Но оно не бесплатно. Энкодер может потерять мелкую структуру, а декодер — восстановить её приблизительно. Поэтому латентное пространство влияет на то, какие детали модель сохраняет легко, а какие вынуждена реконструировать.
Латент — не «маленькая картинка», которую можно открыть обычным просмотрщиком. Это набор чисел с другой геометрией и другой семантикой. Близость двух латентов может соответствовать похожему визуальному содержанию, но не означает, что их можно напрямую интерпретировать как RGB.
Роль энкодера и декодера
Энкодер переводит объект из одного пространства в другое. Для text-to-image системы текстовый энкодер превращает токены в условие; для latent diffusion image encoder сжимает пиксельное изображение в латент. В зависимости от архитектуры один и тот же термин может относиться к разным компонентам, поэтому всегда нужно уточнять, что именно кодируется.
Декодер выполняет обратную задачу: переводит скрытое состояние в формат, который можно визуализировать. Он не «додумывает смысл» как редактор, а восстанавливает пиксельную структуру по тому, что сохранилось в латенте. Если на промежуточном этапе были потеряны тонкие отношения, декодер не обязан восстановить их правильно.
В некоторых генеративных системах нет отдельной пары «текстовый энкодер плюс VAE-декодер» в привычном виде. Авторегрессионная модель может предсказывать визуальные токены, а другой компонент превращает их в изображение. Поэтому схема токены → векторы → латенты → пиксели — полезная карта, но не строгий обязательный конвейер для каждой современной модели.
Если система получает референс, меняется и задача: нейросеть для генерации изображений по фото должна учитывать уже существующую композицию, а не начинать с пустого пространства. В режиме нейросеть для генерации картинок по тексту такой опоры может не быть, поэтому результат сильнее зависит от случайности и формулировки условия.
Почему возникают ошибки в руках, тексте и геометрии
Руки и повторяющиеся детали
Кисти, пальцы и другие мелкие части тела требуют согласованности формы, количества и положения сразу на нескольких масштабах. На ранних шагах модель определяет общую позу, а на поздних пытается совместить локальные детали с этой позой. Если в данных были разные ракурсы, жесты и степени детализации, вероятностный результат может нарушить анатомию.
Надписи
Текст на изображении — это не то же самое, что текст в обычном документе. Ранние генераторы часто не строили буквы посимвольно: они воспроизводили визуальный образ знаков, вывесок и строк. Поэтому надпись могла быть похожа на шрифт, но не складываться в слово. Новые мультимодальные системы лучше удерживают длинные подписи и макеты, но мелкий текст, необычные алфавиты и плотная типографика всё ещё требуют проверки.
Геометрия и отношения
Запрос «красная чашка слева от синей тарелки» содержит несколько сущностей и пространственное отношение. Модель может правильно изобразить чашку и тарелку по отдельности, но перепутать их расположение. Причина в том, что статистическая связь с объектами не гарантирует строгий редакторский контроль координат.
Ошибки не означают, что модель ничего не знает. Они показывают границу между правдоподобным продолжением визуального распределения и точным выполнением формальной инструкции. Для важных результатов нужны итерации, референсы, маски, inpainting или последующая ручная проверка.
Что именно модель учится предсказывать
Во время обучения модель получает множество примеров и задачу, связанную с восстановлением или предсказанием. В DDPM-подобной схеме она видит чистое изображение, к нему добавленный шум и должна предсказать шум, чистое состояние или эквивалентную величину — точный вариант зависит от параметризации. Ошибка между предсказанием и целевым значением используется для обновления весов.
При этом модель не хранит в каждом нейроне отдельную фотографию. Параметры распределяют закономерности по огромному числу связей. Во время генерации они участвуют в вычислении вероятного направления, но не извлекают из базы один готовый файл по ключевой фразе.
Качество зависит не только от архитектуры. Важны состав данных, подписи, разрешение, фильтрация, баланс стилей, вычислительный бюджет и процедура обучения. Если данные плохо отражают редкий объект или язык, модель может быть менее уверенной именно в этой области.
История: от GAN к мультимодальным моделям
GAN: генератор против дискриминатора
В 2014 году работа Generative Adversarial Networks предложила обучать две модели в соревновании. Генератор создаёт образцы, а дискриминатор пытается отличить их от настоящих. Такой подход дал мощный импульс генерации изображений и научил исследователей управлять распределением визуальных данных, но обучение могло быть нестабильным, а разнообразие — ограничиваться.
DALL·E и визуальные токены
В 2021 году OpenAI описала DALL·E как трансформер, который обрабатывает текстовые и визуальные токены в единой последовательности. Это важный этап для идеи, что изображение можно представить не только пикселями, но и дискретными кодами, похожими по роли на элементы языковой последовательности.
Diffusion становится основным направлением
Работа Denoising Diffusion Probabilistic Models показала, как обучать высококачественную генерацию через последовательное удаление шума. Затем Latent Diffusion Models перенесли процесс в сжатое пространство и сделали такие системы практичнее по вычислениям. В этот период сформировались многие понятия, которые сегодня встречаются в интерфейсах генерации: шаги, sampler, guidance и latent.
Трансформеры и масштабирование
Параллельно развивались авторегрессионные системы с визуальными токенами. Parti исследовала масштабирование трансформера для контентных text-to-image задач, а CogView2 показывала, как иерархические трансформеры могут использоваться для более быстрой генерации и редактирования.
Современные мультимодальные модели
Поздние системы всё чаще объединяют обработку текста, изображения и других типов данных. Они могут не только синтезировать картинку, но и анализировать референс, изменять объект, удерживать композицию, работать с несколькими изображениями и уточнять результат в диалоге. Например, DALL·E 3 делала акцент на следовании подробному описанию, а более новые нативно мультимодальные подходы развивают генерацию внутри общей модели, способной работать с текстом и визуальным контекстом.
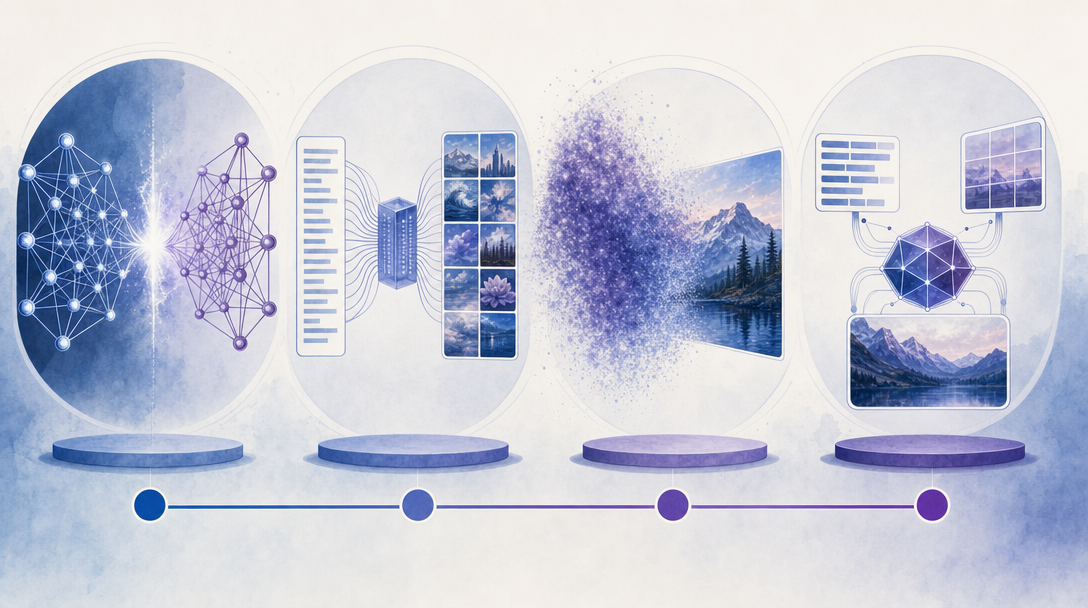
Этапы не заменяют друг друга одной прямой линией. GAN, авторегрессионные токены и diffusion остаются разными семействами подходов; современные продукты могут комбинировать их идеи и компоненты.
Этапы не заменяют друг друга одной прямой линией. GAN, авторегрессионные токены и diffusion остаются разными семействами подходов; современные продукты могут комбинировать их идеи и компоненты. Поэтому за названием вроде нейросеть для генерации изображений Шедеврум или нейросеть для генерации изображений Кандинский всё равно стоит конкретная архитектура: чтобы понять результат, полезнее разобраться в её способе кодирования и генерации, чем ориентироваться только на интерфейс.
Что происходит, когда пользователь нажимает «создать»
- Подготовка запроса. Текст очищается, разбивается на токены и передаётся текстовому энкодеру.
- Формирование условия. Получается контекст из векторов, который будет влиять на генеративный процесс.
- Начальное состояние. Система создаёт случайный шум или использует латент, связанный с исходным изображением, если это режим редактирования.
- Итерации. Модель и sampler выполняют серию шагов denoising, сверяя результат с условием и параметрами guidance.
- Декодирование. Финальный латент проходит через декодер и превращается в пиксельное изображение.
- Постобработка. Система может изменить размер, применить safety-фильтры, добавить варианты или подготовить файл к скачиванию.
Пользователь видит одну кнопку и готовый результат, но внутри происходят десятки или сотни вычислительных операций. Поэтому задержка, потребление памяти и чувствительность к настройкам зависят от разрешения, количества шагов, размера модели и выбранного режима.
Как проверять результат генерации
Оценивать изображение стоит не только по первому впечатлению. Проверьте, соответствует ли композиция задаче, сохранились ли отношения между объектами, читаются ли надписи, нет ли лишних пальцев, повторяющихся деталей, странных отражений и объектов, которые физически не могут находиться в указанном месте. Даже нейросеть для картинок бесплатно может быть полезна для первого варианта, но бесплатный режим не означает автоматическую точность.
- Сначала проверяйте крупную сцену: число объектов, ракурс, расположение и свет.
- Затем — локальные детали: руки, лица, мелкий текст, края предметов и повторяющиеся узоры.
- Для точного результата разделяйте задачу на этапы: генерация, выбор композиции, редактирование объекта и финальная проверка.
- Если изображение должно использоваться в публикации или рекламе, отдельно проверьте права, фактические обещания и отсутствие случайных логотипов. Формат нейросеть для создания картинок бесплатно описывает способ доступа, а не качество, лицензию или пригодность результата для коммерческой задачи.
В редакторе изображений FinderAI такой подход удобно разделять по задаче: отдельно работать с генерацией, редактированием объектов, удалением фона или комбинацией изображений. Но сам факт использования нейросети не отменяет ручную проверку результата.
Главное, что нужно запомнить
Нейросеть не превращает текст в готовую фотографию одним магическим действием. Она проходит через несколько представлений: токены и контекст текста, векторы, латентное состояние, шум и последовательность денойзинга. В конце декодер возвращает результат в пиксельное пространство.
Термины помогают понять интерфейс, но не дают гарантии качества. Diffusion объясняет движение от шума к структуре, sampler — способ пройти этот путь, guidance — силу влияния условия, а энкодер и декодер — переходы между пространствами. Ошибки в руках, тексте и геометрии возникают потому, что правдоподобная статистическая генерация не равна строгому выполнению программы.
Лучший практический вывод прост: относитесь к результату как к версии, которую нужно проверить. Чем важнее точность, тем полезнее разделять генерацию и редактирование, использовать референсы и проверять детали отдельно.
Источники и материалы для дальнейшего чтения
- Generative Adversarial Networks — исходная работа о GAN.
- Denoising Diffusion Probabilistic Models — базовая работа о диффузионной генерации.
- Denoising Diffusion Implicit Models — подход к более эффективной траектории сэмплирования.
- Improved Denoising Diffusion Probabilistic Models — развитие DDPM.
- High-Resolution Image Synthesis with Latent Diffusion Models — латентная диффузия.
- CLIP: Learning Transferable Visual Models From Natural Language Supervision — сопоставление текста и изображений.
- DALL·E: Creating images from text — текстовые и визуальные токены в трансформере.
- Hierarchical Text-Conditional Image Generation with CLIP Latents — DALL·E 2 и CLIP-латенты.
- DALL·E 3 — следование подробному текстовому описанию.
- Scaling Autoregressive Models for Content-Rich Text-to-Image Synthesis — Parti и визуальные токены.
- CogView2 — иерархические трансформеры для text-to-image.
- Classifier-Free Diffusion Guidance — guidance без отдельного классификатора.
- Hugging Face Diffusion Course: Introduction — scheduler и практическая схема diffusion.
- Hugging Face Diffusion Course: Fine-Tuning and Guidance — настройка и guidance.
- Introducing 4o Image Generation — пример развития нативно мультимодальной генерации.
Материал объясняет общие принципы и не описывает внутреннюю реализацию каждой конкретной модели. Архитектуры, названия компонентов и параметры могут отличаться.