Коротко
Нейросеть для генерации изображений превращает текстовое описание в один или несколько визуальных вариантов. В 2026 году это уже не только эксперимент с красивыми картинками: генерация изображений используется для иллюстраций, карточек товаров, концептов, обложек, сторибордов, презентаций и быстрых прототипов.
При этом запрос «нейросеть для картинок» может означать разные задачи. Одному пользователю нужна нейросеть для генерации изображений бесплатно, другому — точное редактирование фотографии, третьему — генерация изображения по фото или подготовка макета с читаемым текстом. Эти сценарии пересекаются, но технически и продуктово это не одно и то же.
В этой статье разбираем, как устроена генерация, какие сервисы доступны пользователям в России, какие модели работают внутри FinderAI, что изменилось со времён первых генераторов и почему малоизвестная модель иногда оказывается полезнее самого громкого названия.
Как менялся интерес к генерации изображений
В поиске пользователи формулируют одну потребность по-разному: кто-то ищет нейросеть для картинок, кто-то — сервис для создания изображения, а кто-то сразу называет знакомый продукт. Для анализа спроса такие формулировки полезно рассматривать не как набор разрозненных SEO-фраз, а как один кластер намерения: человек хочет получить изображение по описанию.
Я проверил динамику трёх близких формулировок через официальный Wordstat API: «нейросеть для генерации изображений», «нейросеть для картинок» и «нейросеть для создания картинок». Для каждой фразы API вернул помесячные значения; затем значения были сложены по годам.
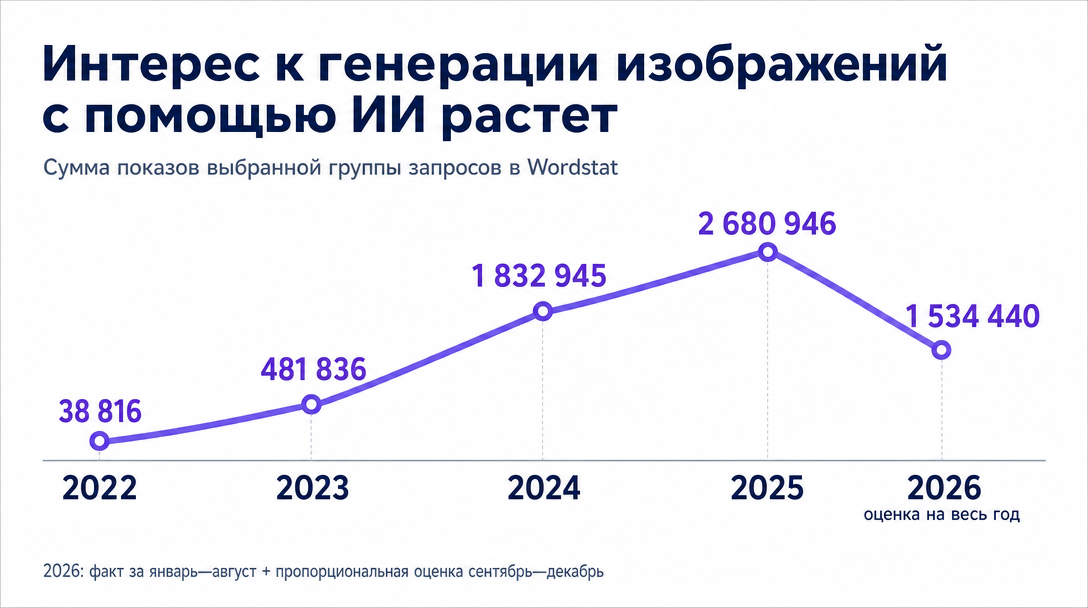
| Период | Сумма показов трёх формулировок | Комментарий |
|---|---|---|
| 2022 | 38 816 | январь—декабрь |
| 2023 | 481 836 | январь—декабрь |
| 2024 | 1 832 945 | январь—декабрь |
| 2025 | 2 680 946 | январь—декабрь |
| 2026 | 1 534 440 | факт январь—август + оценка сентябрь—декабрь |
Картина показывает не равномерный рост, а переход темы из экспериментальной области в массовый пользовательский сценарий: заметное ускорение начинается в 2023 году, а в 2024—2025 годах спрос на выбранную группу формулировок становится значительно выше. Значение за 2026 год рассчитано по фактическим данным января—августа с пропорциональным продолжением на сентябрь—декабрь, поэтому это оценка полного года, а не уже завершённый факт.
Это не перепись аудитории, а снимок поискового интереса. Близкие формулировки могут пересекаться: один человек способен искать одну и ту же задачу разными словами. Поэтому график корректно читать как ориентир масштаба и динамики интереса, а не как число людей или обещание трафика для FinderAI.
Внутри кластера есть несколько разных намерений:
- создать новую картинку по текстовому описанию;
- найти бесплатный или недорогой способ попробовать генерацию;
- выбрать конкретный российский сервис — например, Шедеврум или Kandinsky;
- сгенерировать изображение по фотографии или нескольким референсам;
- перейти от генерации к редактированию уже готового изображения.
В повседневной речи это звучит ещё конкретнее. Одни ищут «нейросеть для картинок бесплатно» или «нейросеть для создания картинок бесплатно», другие — «нейросеть для генерации картинок». Если нужен знакомый российский продукт, формулировка может быть брендовой: «нейросеть для генерации изображений Шедеврум» или «нейросеть для генерации изображений Кандинский». За всеми этими вариантами стоит один вопрос: где быстро получить подходящий визуальный результат и что можно сделать с ним дальше.
Именно поэтому поисковая частотность сама по себе не отвечает на вопрос «какой сервис лучше». Она показывает, что интерес существует, а полезная статья должна помочь выбрать подходящий сценарий и проверить результат.
Генерация, редактирование, фон и комбинация — четыре разные задачи
Генерация по тексту начинается с пустого холста. Пользователь описывает сцену, стиль, композицию, свет, формат и важные объекты. Модель создаёт новый результат, которого не было в исходном файле.
Нейросеть для генерации изображений по фото получает один или несколько референсов. Она может сохранить композиционный мотив, персонажа, предмет или визуальный стиль, но степень сохранения зависит от модели и команды. Это не гарантированная копия исходника.
Редактирование изменяет существующее изображение: объект можно удалить, заменить или перекрасить. Для этой задачи важны маски, понимание сцены и способность модели не менять остальную композицию. В FinderAI это отдельный сценарий на странице редактирования объектов на фото.
Работа с фоном делится ещё на два намерения. Удаление фона — это вырезание объекта и получение изображения без фона; для него есть отдельная страница удаления фона. Замена фона — создание новой сцены вокруг объекта, и она относится к общему AI-редактору изображений FinderAI.
Комбинация изображений объединяет несколько исходников в одну сцену. Это удобно для виртуальной примерки, предметной композиции и коллажей; отдельный сценарий описан на странице комбинации изображений. Не стоит вести пользователя со всех этих запросов на одну и ту же обещающую страницу.
Как технически устроена генерация изображения
1. Текст превращается в числовое представление
Запрос сначала разбивается на токены — фрагменты слов и знаков. Текстовый энкодер преобразует их в набор числовых векторов. В них кодируются не «готовые пиксели», а отношения между понятиями: объект, действие, материал, цвет, положение, стиль и контекст.
Именно поэтому формулировка «красная чашка на деревянном столе, крупный план, мягкий боковой свет» обычно полезнее, чем набор несвязанных прилагательных. Модель получает структуру сцены и понимает, какие признаки должны быть связаны.
2. Работа происходит не обязательно с пикселями
Современные системы часто используют латентное пространство — компактное представление изображения. Вместо прямого расчёта каждого пикселя модель работает со сжатой картой признаков, а затем декодер переводит её обратно в изображение. Латентный подход уменьшает вычислительную стоимость и позволяет обучать модели на больших наборах данных.
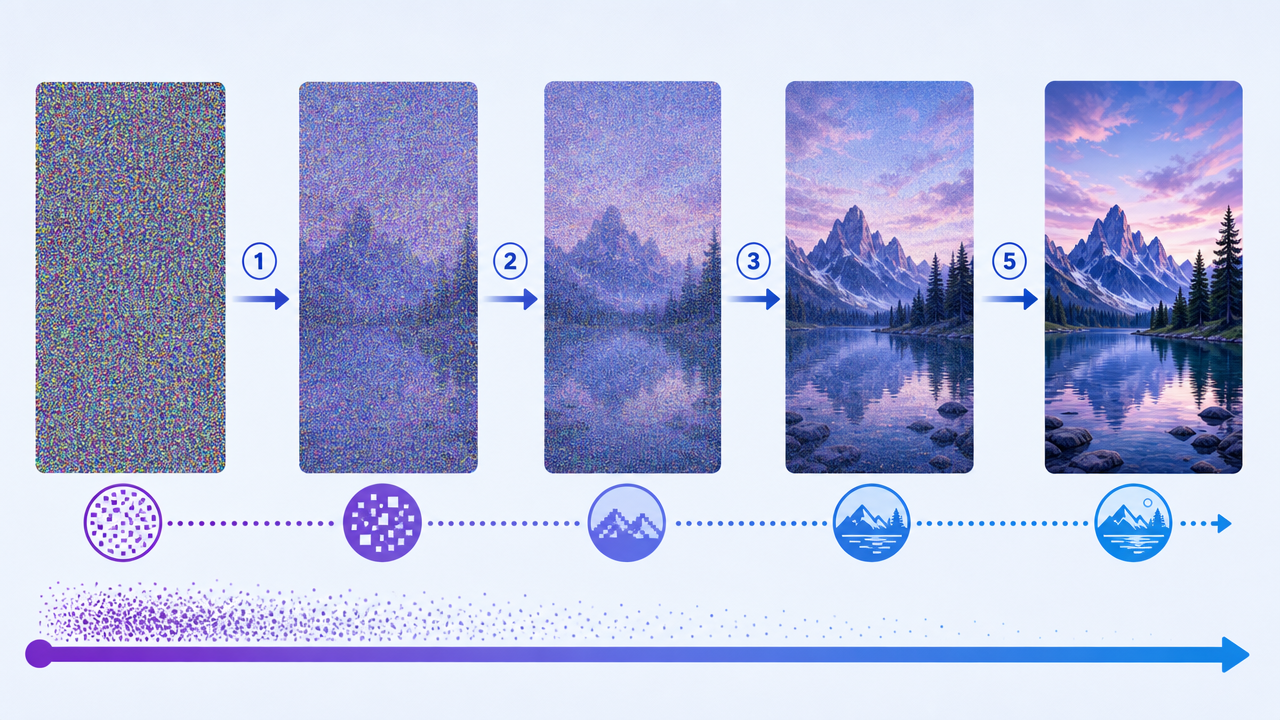
3. Из шума появляется структура
В диффузионной модели обучение можно представить как две связанные процедуры. На прямом шаге к настоящим изображениям постепенно добавляют шум. На обратном шаге нейросеть учится оценивать, какую часть шума нужно убрать, чтобы приблизиться к правдоподобному изображению.
При генерации стартовым состоянием становится случайный шум. На каждом шаге модель сверяет промежуточное состояние с текстовым условием и уточняет форму, цвета, освещение и детали. Это не означает, что она достаёт картинку из базы. Она строит новый вариант из выученного распределения признаков.
Важную роль играет guidance — механизм, который усиливает соответствие условию. Слишком слабое условие даёт красивую, но неточную сцену; слишком сильное может привести к неестественным деталям и повторению словесных шаблонов.
4. Почему появились трансформеры и flow-подходы
В новых системах используются не только классические U-Net-диффузионные архитектуры. Diffusion Transformer разбивает латентное представление на элементы и обрабатывает их механизмами внимания. Flow matching и rectified flow описывают генерацию как более прямую траекторию перехода от шума к изображению. На практике пользователю важен не термин сам по себе, а результат: скорость, точность композиции, качество текста, устойчивость персонажа и стоимость одного запуска.
Мультимодальные модели идут ещё дальше: они могут одновременно понимать текст, изображение и последовательность правок. Поэтому команда «сохрани объект, но замени фон и сделай свет теплее» постепенно становится естественным интерфейсом, а не набором разрозненных масок.
От первых картинок к современным моделям
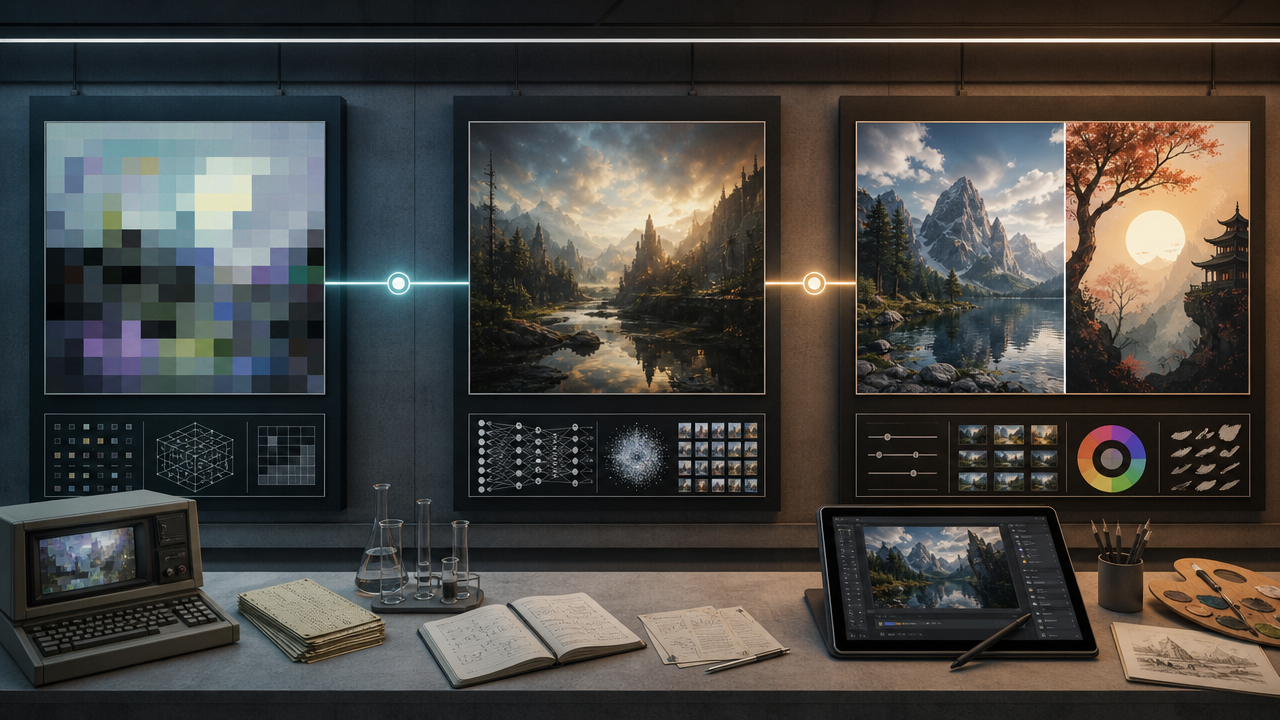
Ранние системы генерации изображений часто выдавали абстрактные или низкодетализированные результаты. Их сильной стороной была демонстрация принципа: сеть может синтезировать новые данные, похожие на примеры обучения. Но человеку было трудно управлять тем, что именно получится.
В 2014 году появились Generative Adversarial Networks — GAN. В классической схеме генератор создаёт образцы, а дискриминатор пытается отличить их от настоящих. Соревнование двух сетей помогало получать более реалистичные изображения, но обучение могло быть нестабильным, а разнообразие результатов — ограниченным.
Следующий большой сдвиг связан с языковым условием. DALL·E показал, что текстовое описание можно связать с визуальным пространством, а DALL·E 2 значительно расширил качество и разнообразие результатов. Затем диффузионные модели стали практической основой многих систем, потому что давали хороший баланс качества, разнообразия и управляемости.
Сейчас прогресс заметен в нескольких направлениях:
- лучше соблюдается сложная композиция и взаимное расположение объектов;
- повышается качество текста на постерах, упаковке и схемах, хотя ошибки всё ещё возможны;
- модели лучше работают с несколькими референсами и последовательными правками;
- уменьшается задержка за счёт дистилляции, ускоренных sampler-ов и flow-архитектур;
- появляются модели, рассчитанные на высокое разрешение, локальные правки и прозрачный фон;
- развиваются механизмы происхождения и маркировки синтетического контента, например SynthID.
При этом прогресс не отменяет проверки. Руки, мелкий текст, логотипоподобные элементы, юридически значимые документы и точные товарные характеристики требуют человеческого контроля.
Какие модели используются в FinderAI
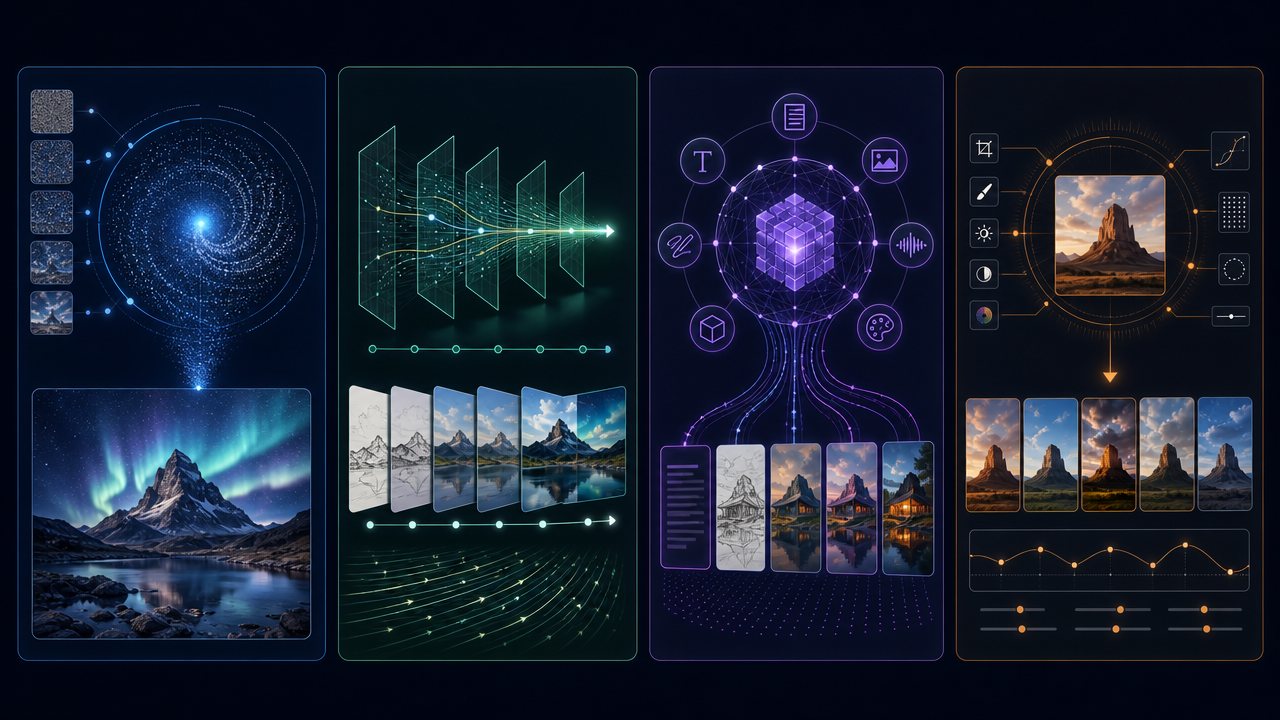
На странице AI-редактора FinderAI сейчас перечислены модели нескольких поставщиков. Состав, цены и доступность могут меняться, поэтому ниже фиксируем именно текущий интерфейс, а не обещание неизменного набора.
- Nano Banana — генерация и редактирование;
- Nano Banana 2 — быстрый рабочий цикл для вариантов и регулярных правок;
- Nano Banana Pro — более дорогой вариант для задач, где важны качество и контроль;
- Nano Banana Lite — облегчённый вариант для быстрых итераций;
- Qwen Image — модель с акцентом на генерацию и работу с текстом в изображении;
- Qwen Image 3 — более новая позиция в линейке FinderAI;
- Grok Imagine и Grok Imagine v2.0 — генерация и редактирование;
- GPT Image 2.0 — генерация и редактирование с несколькими уровнями качества;
- GPT Image 2.5 Flare — вариант для быстрых итераций;
- GPT Image 2.5 Sunburst — вариант для более требовательных сценариев.
Практическое правило простое: начинайте с недорогой быстрой модели, если проверяете идею или перебираете композиции. Для финальной обложки, рекламного макета или сложного редактирования сравните несколько вариантов и выберите тот, где меньше ручных исправлений. Стоимость на странице FinderAI указана за изображение и может зависеть от качества и выбранной модели.
Новинки и направления, за которыми стоит следить
Рынок развивается быстрее, чем успевают обновляться обзоры. Поэтому полезно разделять «модель доступна в FinderAI» и «модель интересна как отраслевое направление».
Imagen и современные закрытые системы
Линейка Imagen от Google DeepMind показывает, как закрытые модели двигаются в сторону фотореализма, скорости и лучшего понимания сложного описания. Gemini Image и Nano Banana развивают не только text-to-image, но и редактирование, композицию нескольких изображений и работу с последовательными инструкциями. Наличие модели в конкретном продукте не следует автоматически понимать как наличие того же API или тарифа в другом сервисе.
Qwen Image и нативный текст
Qwen Image интересна тем, что делает читаемый текст и типографику одним из центральных сценариев. Это важно для постеров, карточек товара и инфографики, но даже при улучшении лучше проверять каждую букву вручную. Текст на изображении — один из самых строгих тестов генератора.
HunyuanImage и большие мультимодальные модели
HunyuanImage 2.1 и HunyuanImage 3.0 показывают направление, в котором генерация объединяется с мультимодальным пониманием. Такие модели интересны не только чистым созданием картинки, но и тем, что могут лучше учитывать изображение-референс, смысл сцены и инструкцию пользователя.
FLUX, Stable Diffusion, PixArt и Sana
FLUX.1 стал заметным представителем flow transformer-подхода. Stable Diffusion остаётся важной экосистемой для локального запуска, LoRA, ControlNet и специализированных пайплайнов. PixArt-Σ исследует эффективную генерацию высокого разрешения, а Sana — вычислительно эффективный путь к изображениям вплоть до 4K в исследовательском описании.
Эти модели не нужно называть «лучшими вообще». Открытая модель может быть удобнее для локального контроля, закрытая — стабильнее для готового сервиса, а маленькая — выгоднее для массовых вариантов. Выбор зависит от задачи, лицензии, скорости и требований к конфиденциальности.
Малоизвестные модели, о которых полезно знать
Помимо популярных названий существуют модели и исследовательские проекты, которые редко встречаются в массовых русскоязычных подборках:
- CogView4 — китайская text-to-image модель с поддержкой широкого диапазона разрешений;
- HunyuanDiT — diffusion transformer Tencent с акцентом на понимание китайского и английского текста;
- PixArt-α и PixArt-Σ — семейство, исследующее эффективное обучение и высокое разрешение;
- Sana — проект с линейным attention и фокусом на эффективность;
- AuraFlow — flow-модель в открытой экосистеме, интересная как эксперимент с альтернативной архитектурой;
- AltDiffusion — пример работы над многоязычной text-to-image генерацией;
- HunyuanImage-3.0 — направление к нативной мультимодальной генерации.
«Малоизвестная» не значит «хуже». Иногда проект не получил массового интерфейса, имеет ограниченную лицензию или рассчитан на исследователей. Перед коммерческим использованием нужно проверить лицензию, происхождение обучающих данных, ограничения API и условия распространения результата.
Какие российские сервисы предоставляют генерацию изображений
Пользователям в России доступны несколько заметных продуктов и платформ. У них различаются интерфейс, набор моделей, регистрация, тарифы, права на результат и ограничения.
Шедеврум и YandexART
Шедеврум — продукт Яндекса для создания изображений и видео по описанию. В материалах Яндекса он связывается с моделями YandexART и YandexGPT. Это удобный вариант для быстрых экспериментов на русском языке и просмотра публичной ленты, но сценарий социальной платформы отличается от рабочего редактора с историей правок и выбором нескольких коммерческих моделей.
Kandinsky и Fusion Brain
Kandinsky — генеративная модель Сбера, а Fusion Brain — интерфейс для работы с генерацией и связанными возможностями. Сервис особенно известен русскоязычным пользователям и позволяет создавать изображения по текстовому описанию. Версию модели, ограничения и условия нужно смотреть в текущем интерфейсе, потому что линейка развивается.
GigaChat
GigaChat позиционируется как мультимодальная русскоязычная система и заявляет возможность не только отвечать на вопросы и работать с текстом, но и создавать изображения. Это пример, когда генерация встроена в диалоговый ассистент, а не вынесена в отдельную студию.
FinderAI
FinderAI объединяет доступ к нескольким моделям изображений в одном интерфейсе и рассчитан на рабочий сценарий: сгенерировать, сравнить, отредактировать и сохранить вариант. Начать можно со страницы нейросети для картинок и AI-редактора. Для смежных задач есть редактирование объектов, удаление фона и объединение изображений.
Если задача ещё не определена, начать можно с FinderAI и выбрать подходящий сценарий по типу результата.
Другие сервисы и агрегаторы, доступные пользователям в России
Кроме разработчиков собственных моделей, есть российские платформы-агрегаторы. Они дают доступ к нескольким нейросетям через один интерфейс и оплату в рублях, но не обязательно обучают модели самостоятельно. Это важное различие при сравнении.
- Gerwin AI — платформа с инструментами для текстов, изображений, видео, музыки и других задач; состав доступных моделей нужно проверять в текущем кабинете.
- BotHub — сервис с отдельным разделом генерации изображений и выбором моделей.
- GPTunnel — мультисервисная платформа с генерацией изображений, каталогом моделей и отдельной страницей цен.
- PR-CY AI-генератор — инструмент для создания изображения по текстовому описанию; перед использованием стоит проверить текущие лимиты и условия.
Такое сравнение нужно обновлять: цены, бесплатные лимиты, названия моделей и доступность отдельных функций меняются быстрее, чем поисковые статьи.
Сравнивать сервисы только по слову «бесплатно» недостаточно. Проверьте лимиты, качество на русском тексте, наличие референсов, повторяемость персонажа, права на коммерческое применение и возможность скачать результат в нужном размере.
Как написать запрос, который легче контролировать
Хороший промпт — не обязательно длинный литературный абзац. Он должен сообщить модели задачу, главный объект, окружение, композицию, свет, стиль и формат.
- Задача: «создай обложку статьи» или «сгенерируй рекламный кадр».
- Объект: что должно быть в центре и какие признаки обязательны.
- Сцена: где находится объект, какое время суток, какие материалы и фон.
- Композиция: крупный план, вид сверху, свободное место слева, вертикальный кадр.
- Свет и настроение: мягкий дневной свет, студийная съёмка, спокойная лабораторная атмосфера.
- Ограничения: без логотипов, без случайного текста, без лишних объектов.
Например: «Создай широкую обложку для статьи о генерации изображений: исследовательница в лаборатории направляет поток светящихся символов на прозрачный экран, справа возникает горный пейзаж, слева оставить свободное тёмное пространство, современная editorial-иллюстрация, без логотипов и читаемых надписей, формат 16:9».
Для итерации меняйте одну переменную за раз. Если одновременно менять стиль, композицию, количество объектов и формат, трудно понять, почему результат стал лучше или хуже.
Ограничения и ответственное использование
Генеративная модель не является источником фактов и не гарантирует точность. Она может исказить надпись, количество пальцев, геометрию предмета, внешний вид товара или узнаваемость человека. Для документов, медицинских и юридических материалов, маркировки, инструкций и рекламы нужен обязательный контроль специалиста.
Также нужно учитывать права на исходные изображения, лица людей, товарные знаки и стили живых авторов. Не загружайте конфиденциальные фотографии и документы, если не понимаете условия конкретного сервиса. Для коммерческой публикации сохраняйте исходный промпт, дату, модель и информацию о лицензии.
FAQ
Есть ли нейросеть для генерации изображений бесплатно?
Есть сервисы с бесплатным режимом или ограниченными пробными запросами, но «бесплатно» не всегда означает отсутствие лимитов, регистрации или ограничений на коммерческое использование. Условия нужно проверять на странице конкретного продукта.
Что выбрать: нейросеть для генерации изображений или редактор?
Если холст пустой — начинайте с генерации по описанию. Если у вас уже есть фото — выбирайте редактирование или генерацию по референсу. Для белого фона и каталожной вырезки нужен сценарий удаления фона, а не обычная генерация.
Можно ли создать картинку по фото?
Да, многие современные модели принимают изображение как референс. Но результат может изменить детали, лицо, пропорции и текстуру. Формулируйте, что нужно сохранить, и проверяйте итог рядом с оригиналом.
Какая модель лучше?
Универсального победителя нет. Для быстрых вариантов важны скорость и стоимость, для макета — текст и композиция, для редактирования — сохранение исходных деталей, для коммерческой задачи — условия лицензии и стабильность результата.
Вывод
Генерация картинок по описанию прошла путь от экспериментальных пиксельных образов до систем, которые умеют создавать сцены, работать с референсами и выполнять последовательные правки. Но технический прогресс не отменяет постановку задачи и проверку результата.
Если нужно попробовать несколько подходов в одном рабочем интерфейсе, откройте AI-редактор FinderAI. Начните с короткого понятного запроса, сравните варианты и затем уточняйте только те параметры, которые действительно влияют на задачу.
Источники и дополнительные материалы
- OpenAI: DALL·E — создание изображений из текста
- OpenAI: DALL·E 2
- OpenAI: DALL·E 3
- OpenAI API: генерация изображений
- Generative Adversarial Nets, 2014
- Denoising Diffusion Probabilistic Models
- Latent Diffusion Models
- Attention Is All You Need
- Imagen: Photorealistic Text-to-Image Diffusion Models
- Stability AI: Stable Diffusion 3.5
- FLUX.1 dev, модельная карта
- Qwen Image: native text rendering
- HunyuanDiT, модельная карта
- HunyuanImage 3.0
- PixArt-α
- PixArt-Σ
- Sana
- CogView4
- Google DeepMind: Imagen
- Google: Gemini 2.5 Flash Image
- Сбер: Kandinsky
- Fusion Brain
- Яндекс: Шедеврум и YandexART
- GigaChat
- Gerwin AI
- BotHub: генерация изображений
- GPTunnel
- PR-CY AI-генератор
- Google DeepMind: SynthID